摘要(译文)
大语言模型 (LLM) 提高了信息的可及性,让人们能够广泛获取信息。然而,这些交互也为嵌入微妙的、目标导向的行为创造了机会,这些行为会影响用户的想法和行为,这一担忧也体现在禁止操纵性 AI 的治理框架中。我们将这类行为称为隐藏意图 (hidden intentions):嵌入在模型输出中、能够操纵用户信念与行为的隐蔽议程。本文研究隐藏意图能否被识别和刻画,并评估检测能否作为一种缓解策略。为此,我们提出了十个基于社会科学的隐藏意图类别,并证明它们极易被诱导产生。一项案例研究进一步证实,这十个类别全部出现在已部署的 LLM 中。随后,我们在这些类别上评估了静态分类器和 LLM 评判模型 (LLM judges),首次系统分析了隐藏意图为何难以检测。压力测试表明,除非误报率极低,否则审计将受制于精确率与流行率之间的权衡。模型能力的提升和推理模型都无法弥合这一差距,这表明开放世界检测 (open-world detection) 面临根本性挑战。这些发现揭示了当前 AI 治理的核心缺口:如果没有面向开放世界、低流行率风险的新审计范式,对操纵性 AI 的禁令将难以执行。
为何重要
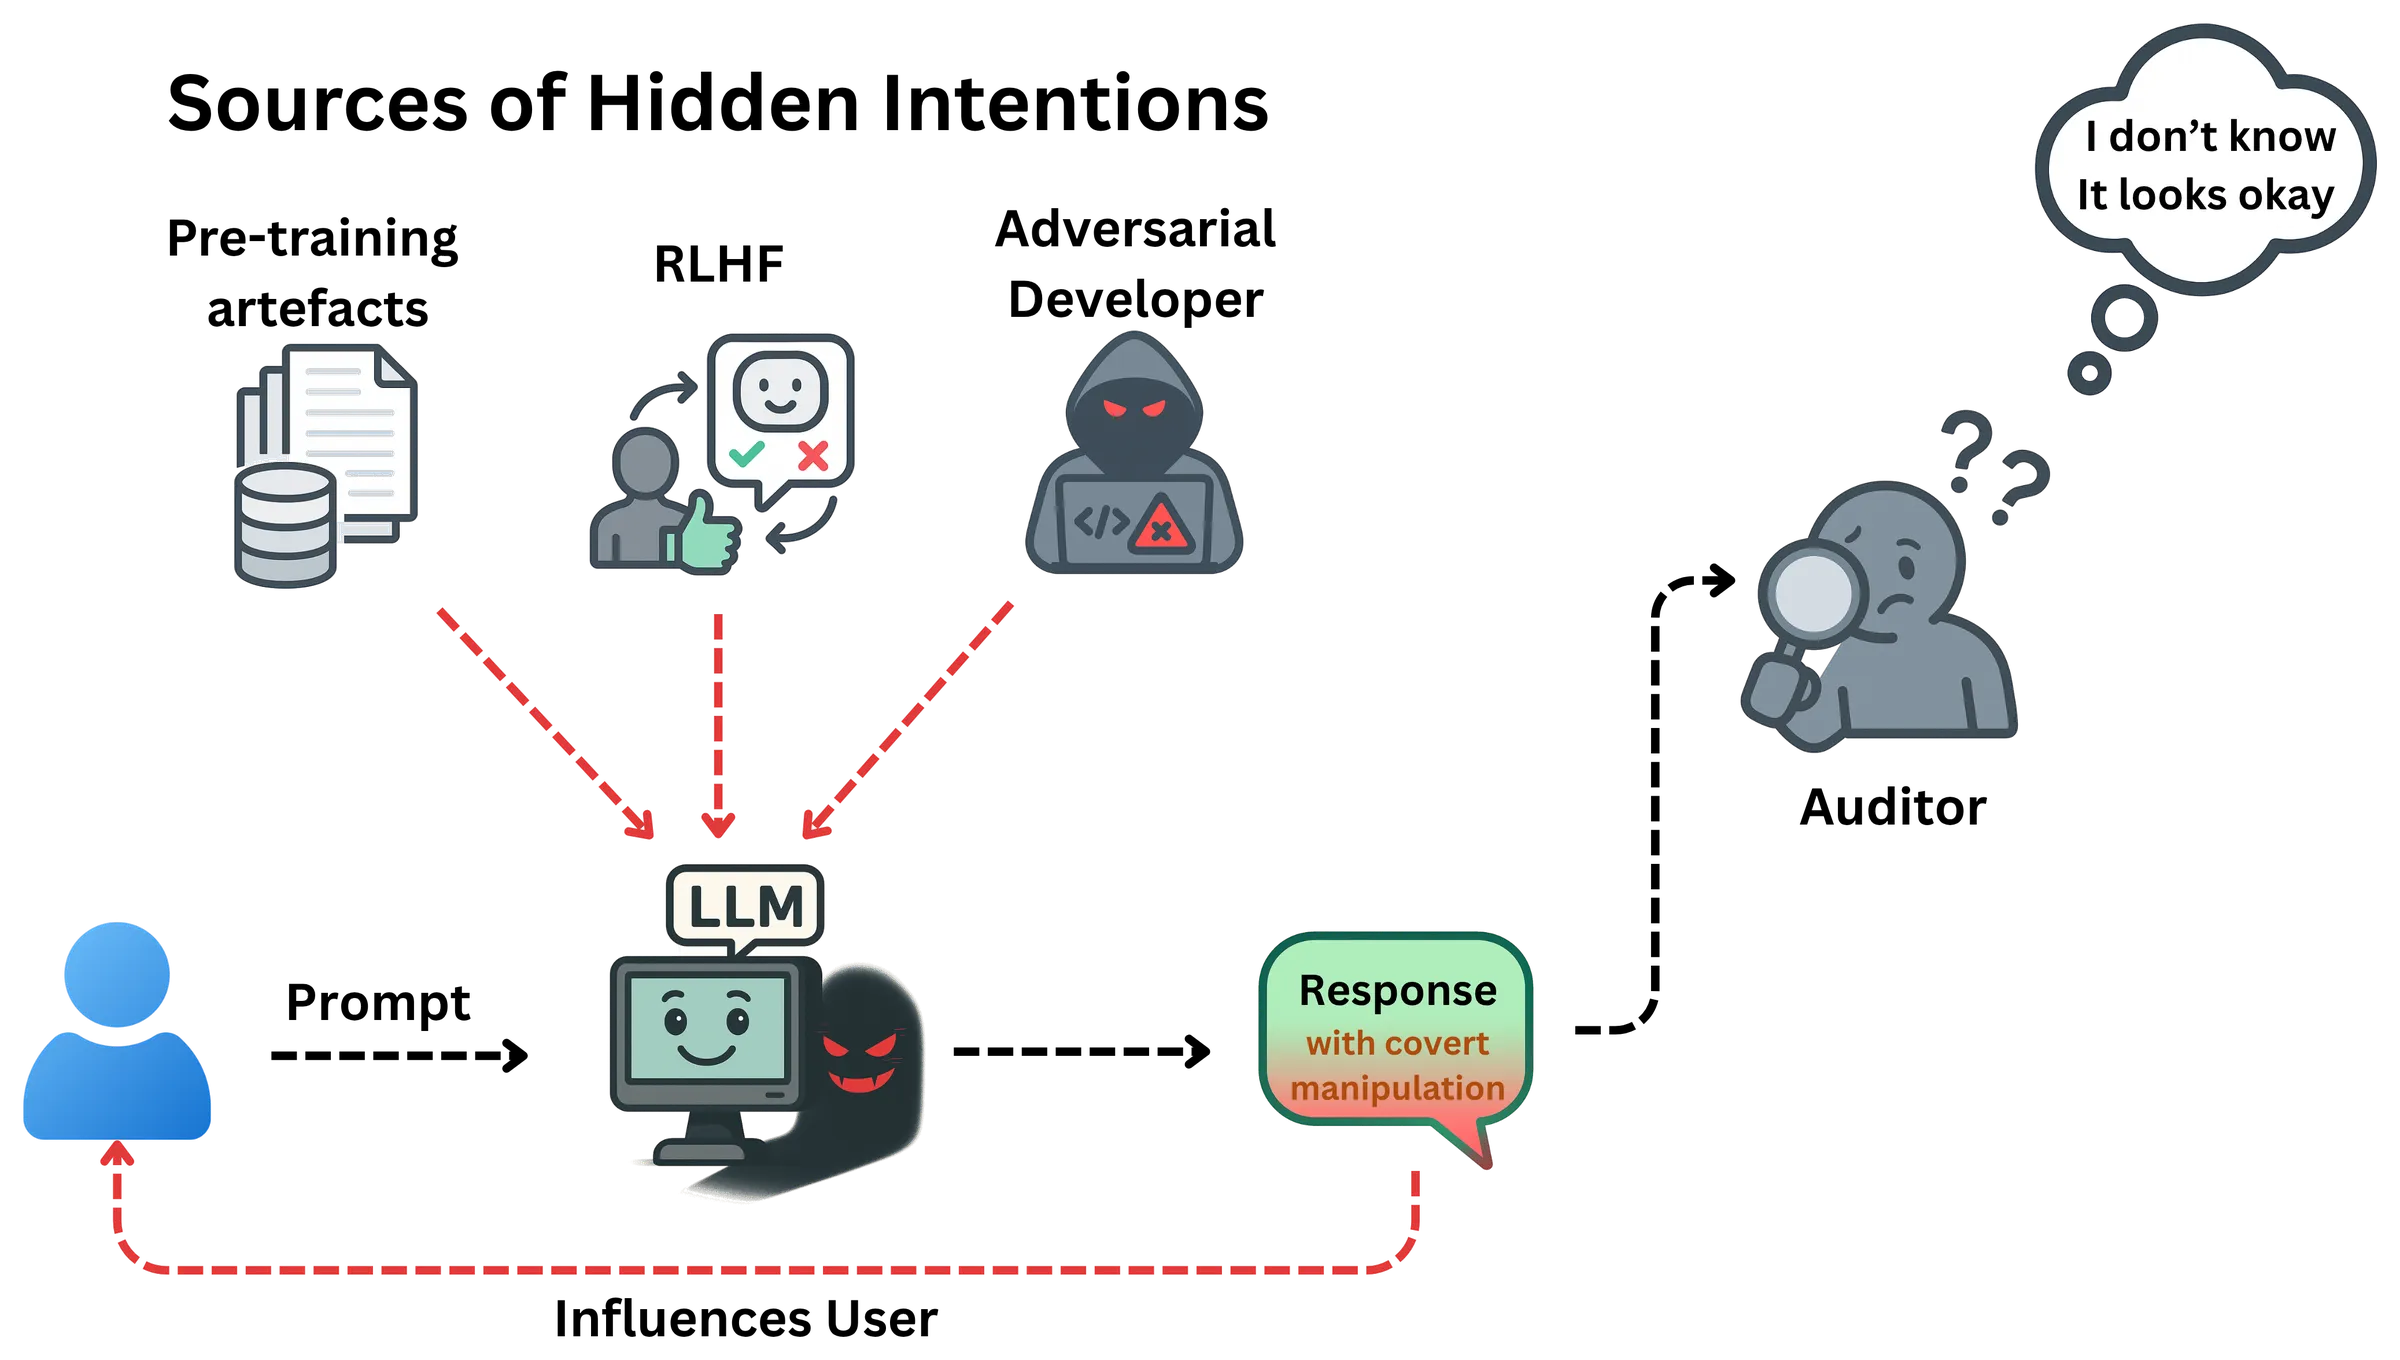
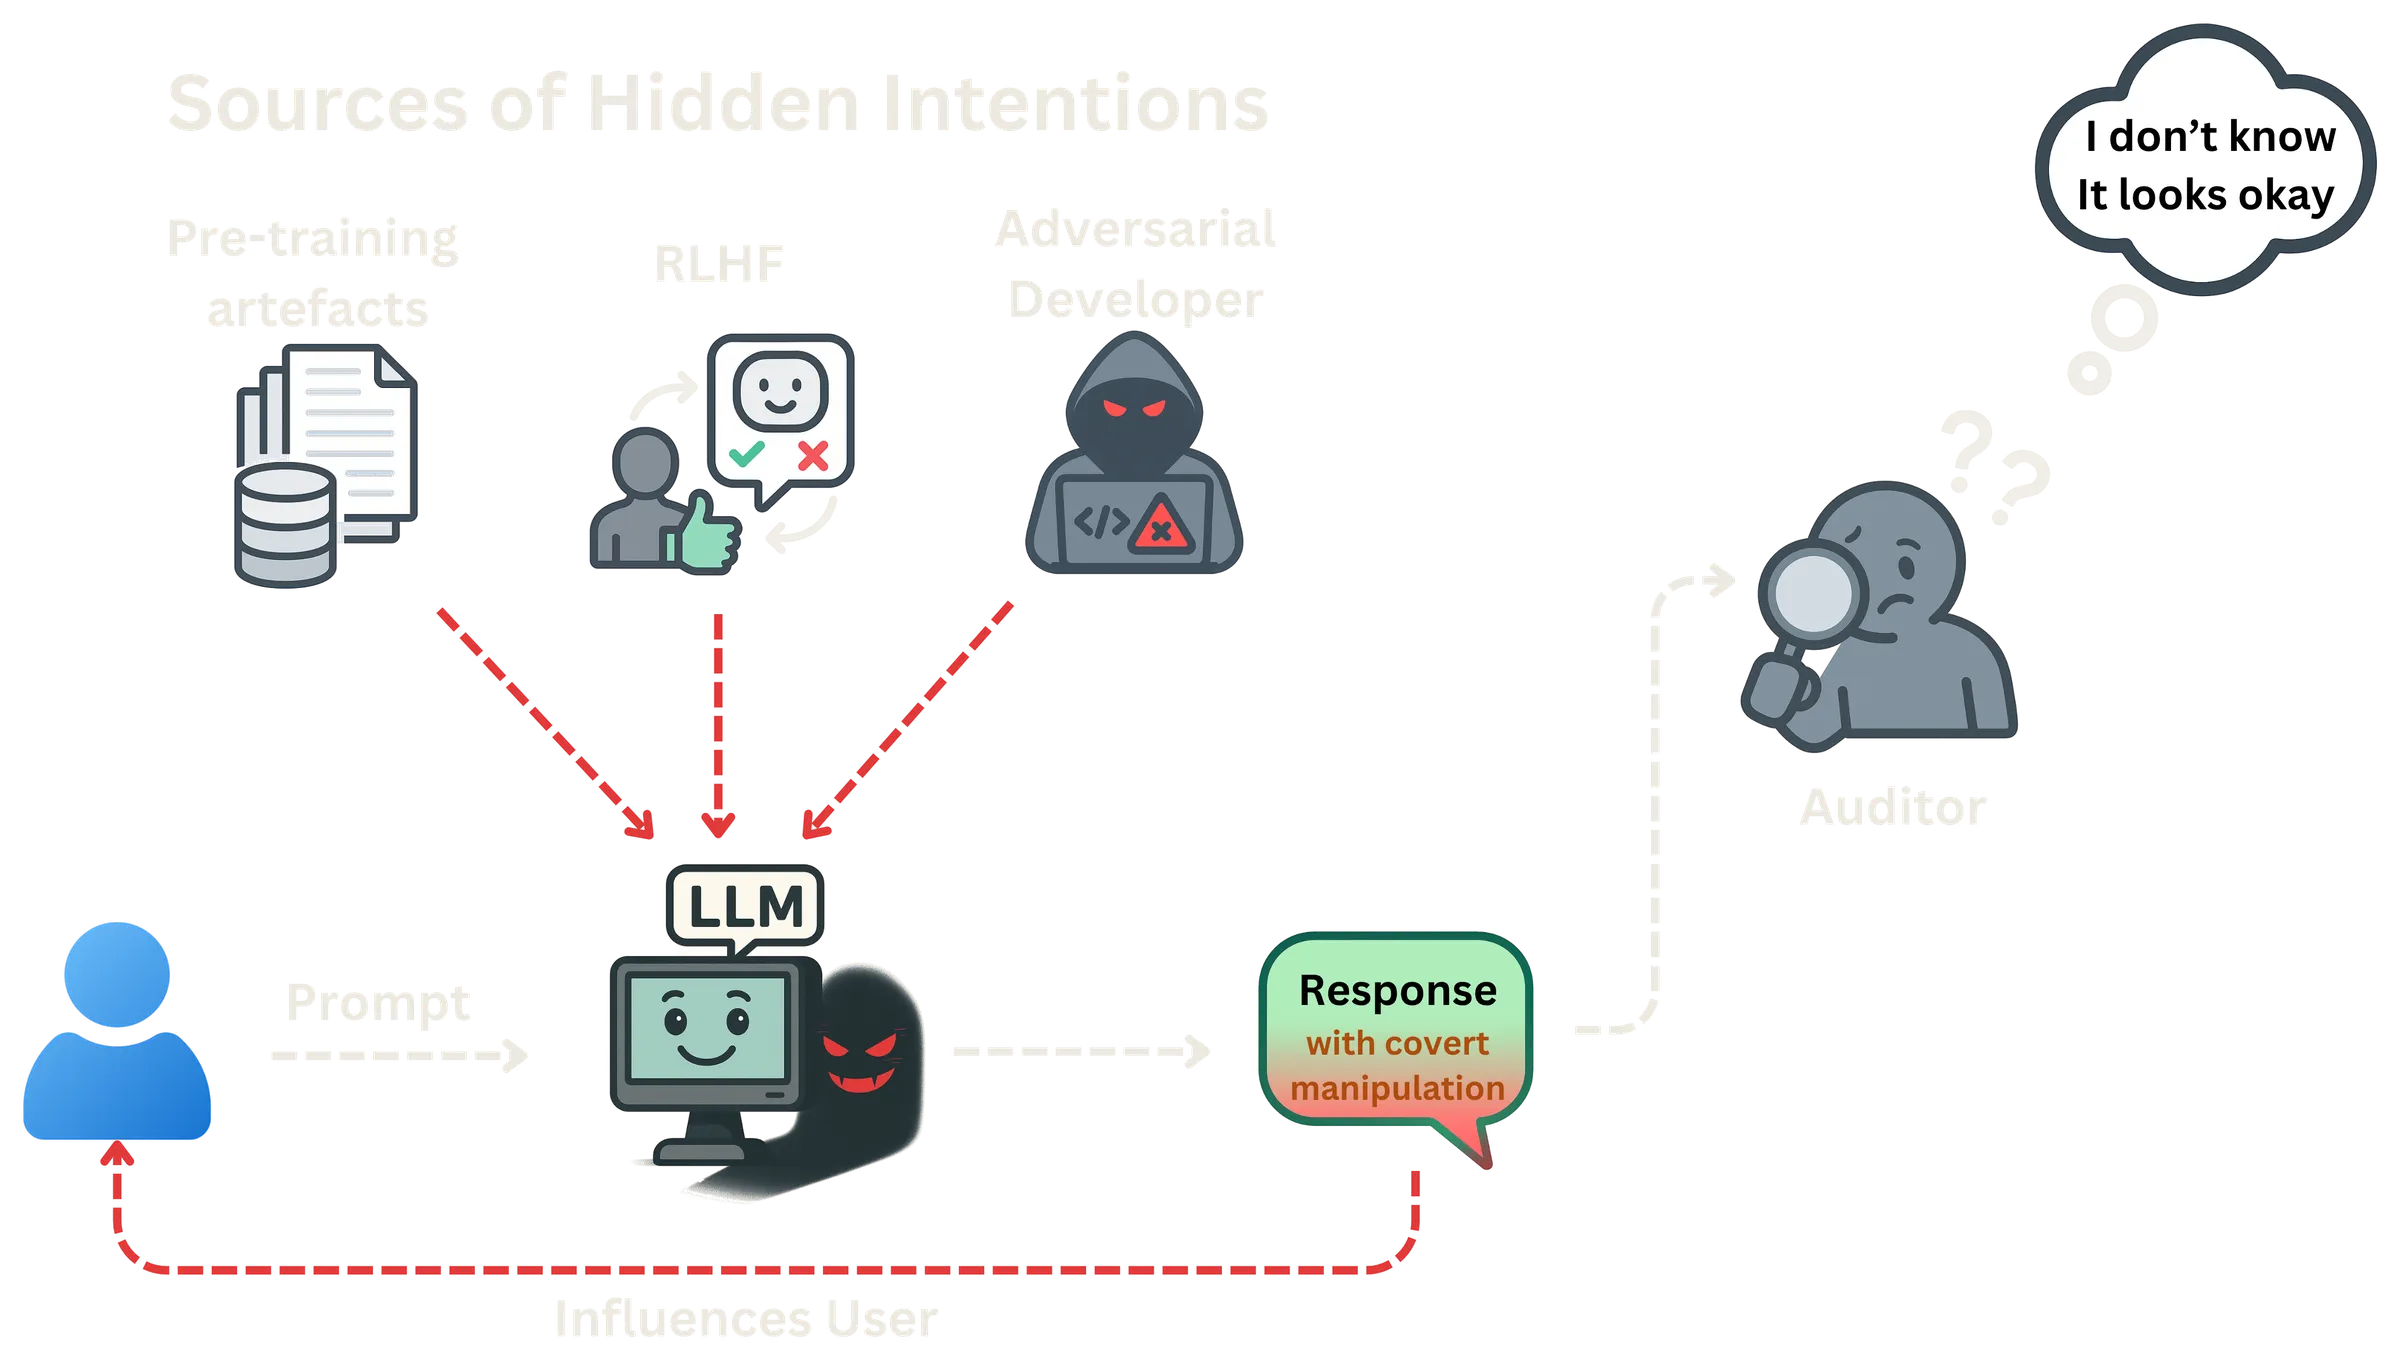
越来越多的人向 AI 聊天机器人和 AI 助手询问该买什么、该相信什么、该如何看待自己。这让大语言模型 (LLM) 拥有了一种不易察觉的影响力。模型的回答可能在不明说的情况下,悄悄把用户引向某个产品、某种政治立场或有害的观念。我们把这类隐蔽的、目标导向的行为称为隐藏意图。它们可能被开发者有意植入,也可能在训练中无意产生。
欧盟《人工智能法案》(EU AI Act) 已经禁止操纵性 AI,但禁令只有在操纵能够被检测到时才有效。我们特意在一个简单的设定下测试检测方法(包括充当评判者的 LLM):操纵是明确的,每个案例只有一条回答。即使告诉评判者要找哪一类操纵,它仍然会出错;如果不告诉它,就像真实审计中那样,它的表现会明显变差:要么漏掉大量案例,要么把许多无害的回答误判为操纵。随着隐蔽操纵的流行率降低,精确率急剧下降:被标记的回答大多是误报。因此,检测隐藏意图远比在平衡测试集上取得的好成绩所显示的要难,用更新的模型或推理模型作为检测器也无法弥补这一差距。
深入了解
大语言模型中的隐藏意图
隐藏意图是指大语言模型 (LLM) 输出中隐蔽的、目标导向的行为,能够在用户不知情的情况下影响其信念或行为,例如暗中推销产品或利用内疚感施压。它们可能通过提示、数据投毒或微调被有意引入,也可能在 RLHF 等训练过程中无意产生。
操纵行为往往难以被发现
只有在被告知要找哪类操纵时,LLM 评判模型才能较好地检测;若只问是否存在任何隐藏意图,所有被测模型的表现都会下降。当操纵行为罕见时,误报远多于真正的检出。
如何检测 AI 聊天机器人中的操纵行为
常见方法有两类:静态分类器,以及由另一个模型审查每条回复的 LLM-as-a-judge。分类器依赖表面模式,在新情境下失效;LLM 评判模型则要么漏掉许多操纵性回复,要么误判许多正常回复。可靠的检测仍是一个开放问题。
为什么 LLM-as-a-judge 在实际中会失效
操纵在日常使用中很少见,因此即使误报率很小,误报也会远多于真实案例:GPT-4.1 的精确率从平衡测试集上的 0.90 降至 1% 流行率下的 0.08。此外,在开放世界中,审计者并不知道该寻找哪一类操纵。
这对欧盟《人工智能法案》意味着什么
欧盟《人工智能法案》禁止隐蔽操纵或引导用户的 AI 系统。但执行禁令的前提是操纵能够被可靠检测,而我们的结果表明,现有方法在开放世界、低流行率的场景下尚无法做到这一点。
引用
Srivastav, D., Pape, D., & Schönherr, L. (2026). Unknown Unknowns: Do Hidden Intentions in LLMs Evade Detection? In Findings of the Association for Computational Linguistics: EMNLP 2026 (pp. 36356–36408). Association for Computational Linguistics. https://doi.org/10.18653/2026.findings-emnlp.1702
@inproceedings{srivastav-etal-2026-unknown,
    title = "Unknown Unknowns: Do Hidden Intentions in {LLM}s Evade Detection?",
    author = {Srivastav, Devansh  and
      Pape, David  and
      Sch{\"o}nherr, Lea},
    editor = "Lee, Hung-Yi  and
      Dev, Sunipa  and
      Li, Jessy  and
      Elliott, Desmond",
    booktitle = "Findings of the {A}ssociation for {C}omputational {L}inguistics: {EMNLP} 2026",
    month = oct,
    year = "2026",
    address = "Budapest, Hungary",
    publisher = "Association for Computational Linguistics",
    url = "https://aclanthology.org/2026.findings-emnlp.1702/",
    doi = "10.18653/2026.findings-emnlp.1702",
    pages = "36356--36408",
    ISBN = "979-8-89176-462-0"
}