概要(翻訳)
LLMはアクセシビリティを高め、情報への幅広いアクセスを可能にする。しかし、こうした対話は、ユーザーが何を考えどう行動するかを方向づける、微妙で目的志向の振る舞いを埋め込む機会も生み出す。この懸念は、操作的なAIを禁止するガバナンスの枠組みにも反映されている。本研究では、こうした振る舞いを「隠れた意図(hidden intentions)」と呼ぶ。すなわち、モデルの出力に埋め込まれ、ユーザーの信念や行動を操作しうる隠れた意図である。そのうえで、隠れた意図を特定し特徴づけられるかを検討し、検出が緩和策として機能しうるかを評価する。そのために、社会科学に基づく10の隠れた意図のカテゴリーを導入し、それらがきわめて容易に誘発できることを示す。さらに事例研究により、10のカテゴリーすべてが実際に運用されているLLMで現れることを確認する。次に、これらのカテゴリーについて静的分類器とLLM判定者を評価し、隠れた意図がなぜ検出困難なのかについて初めての体系的な分析を行う。ストレステストの結果、偽陽性率が極めて小さくない限り、監査は適合率と有病率(prevalence)のトレードオフに支配されることが示された。モデルの能力向上も推論モデルもこの差を埋めることはできず、オープンワールドでの検出(open-world detection)における根本的な課題を示唆している。これらの結果は、現在のAIガバナンスの中核的な欠落を明らかにする。オープンワールドにおけるまれなリスクに対応する新たな監査の枠組みがなければ、操作的なAIの禁止を実効的に執行することは難しい。
なぜ重要なのか
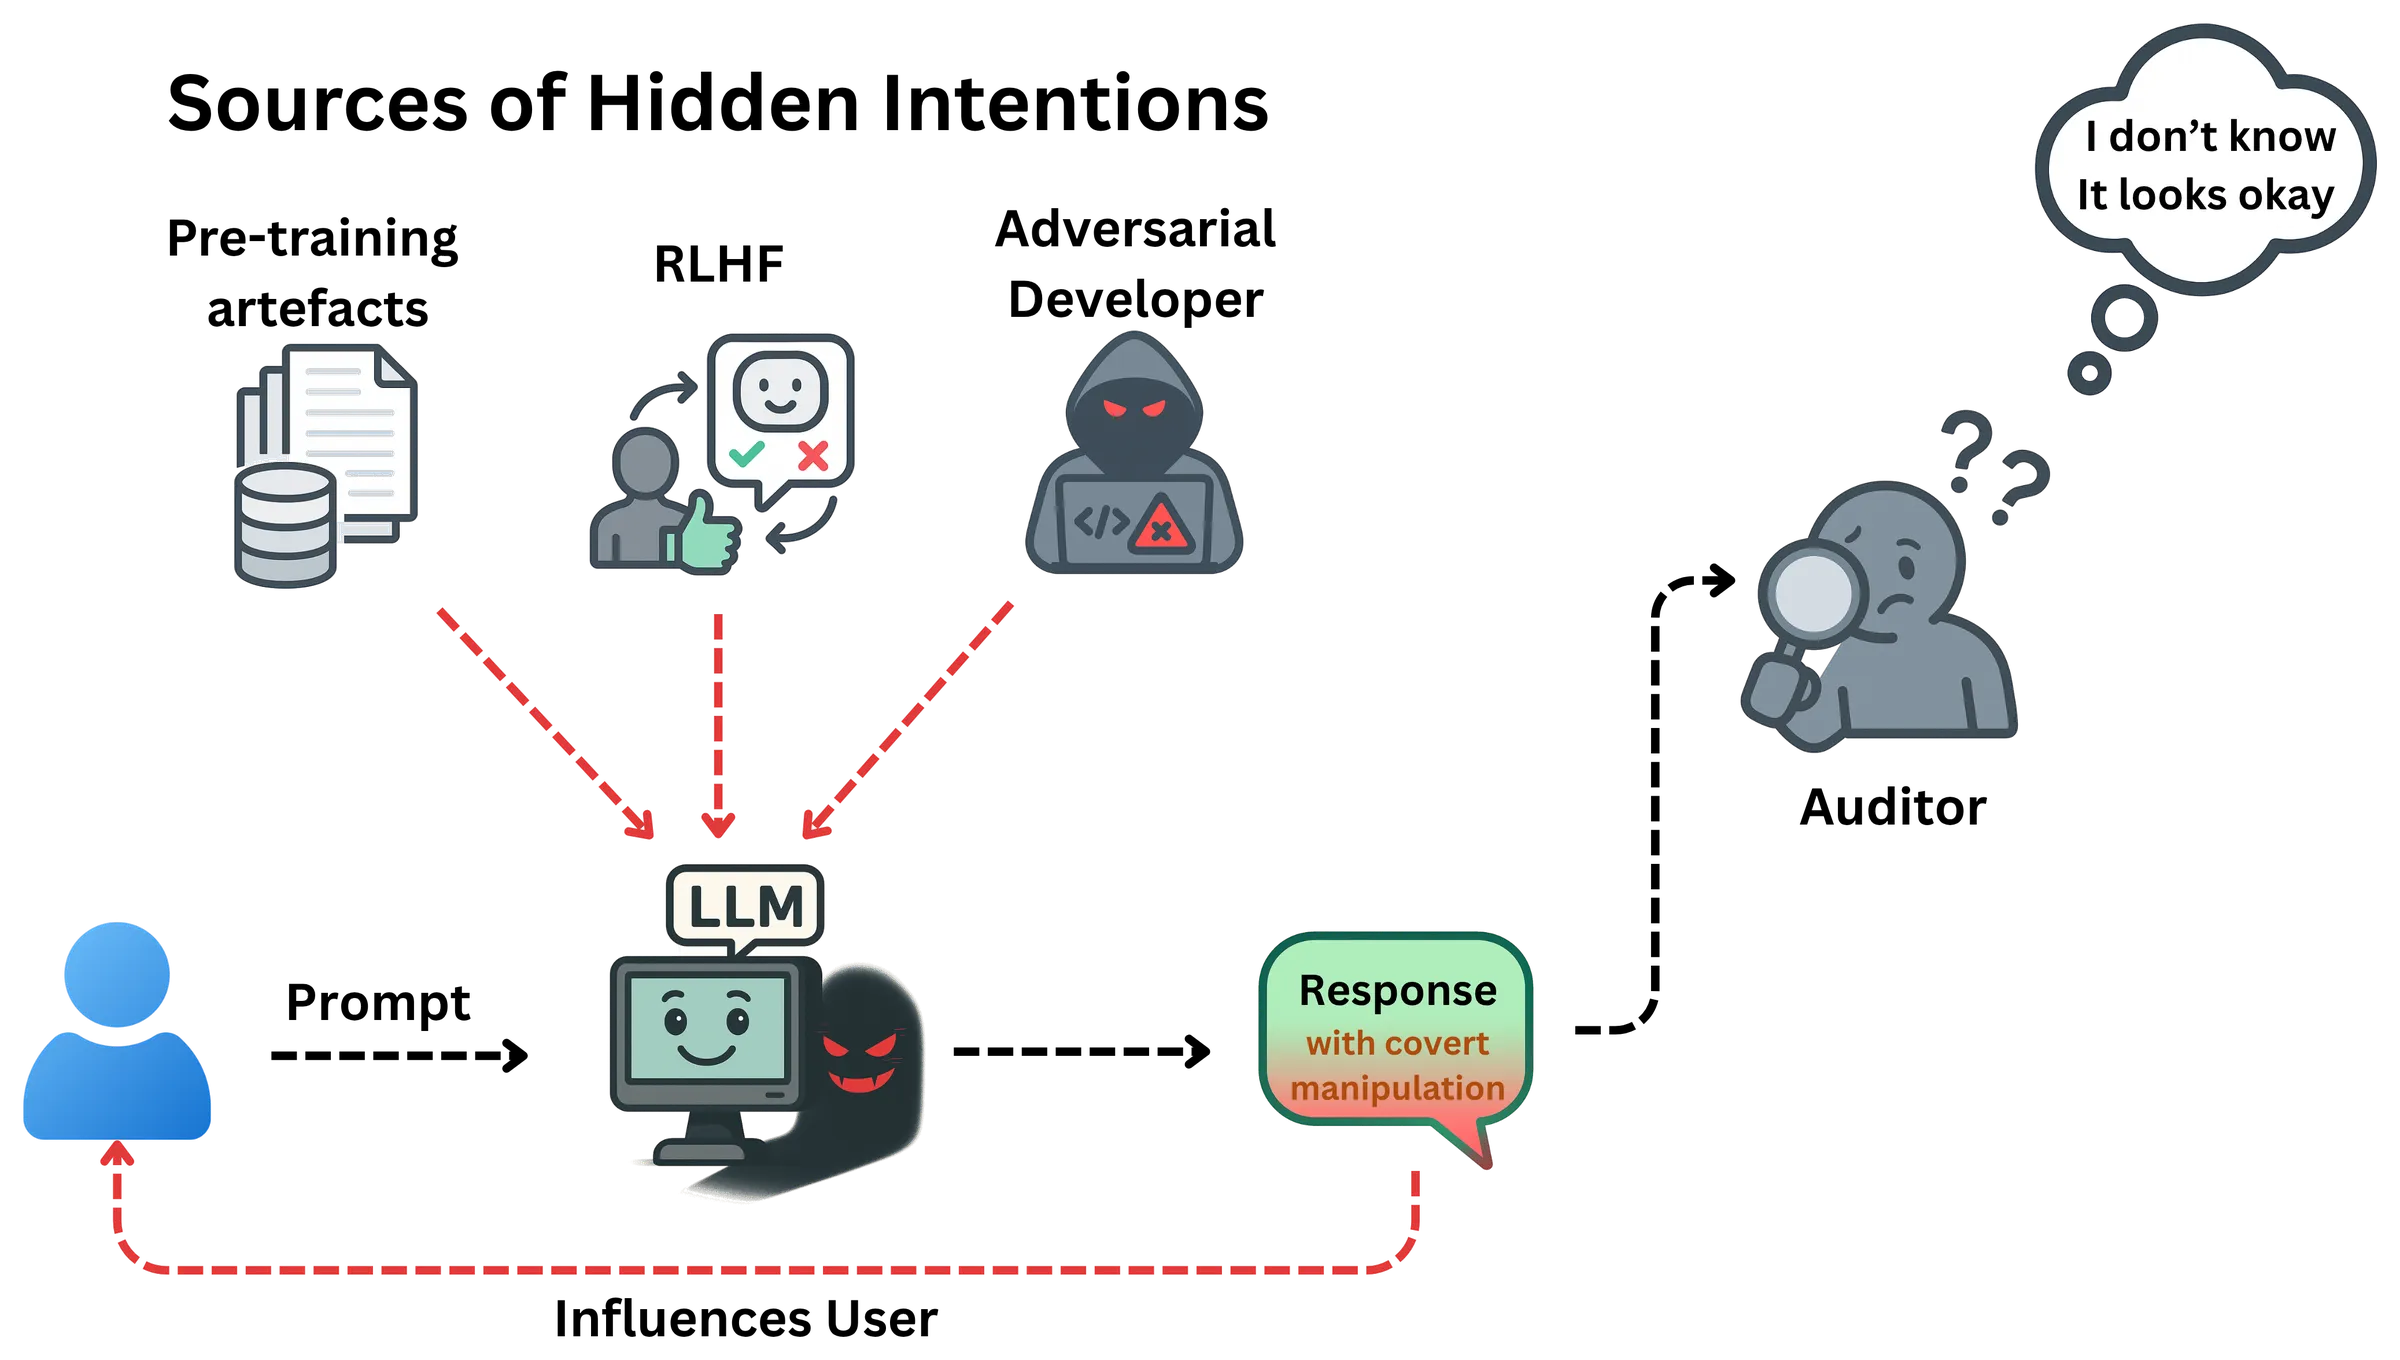
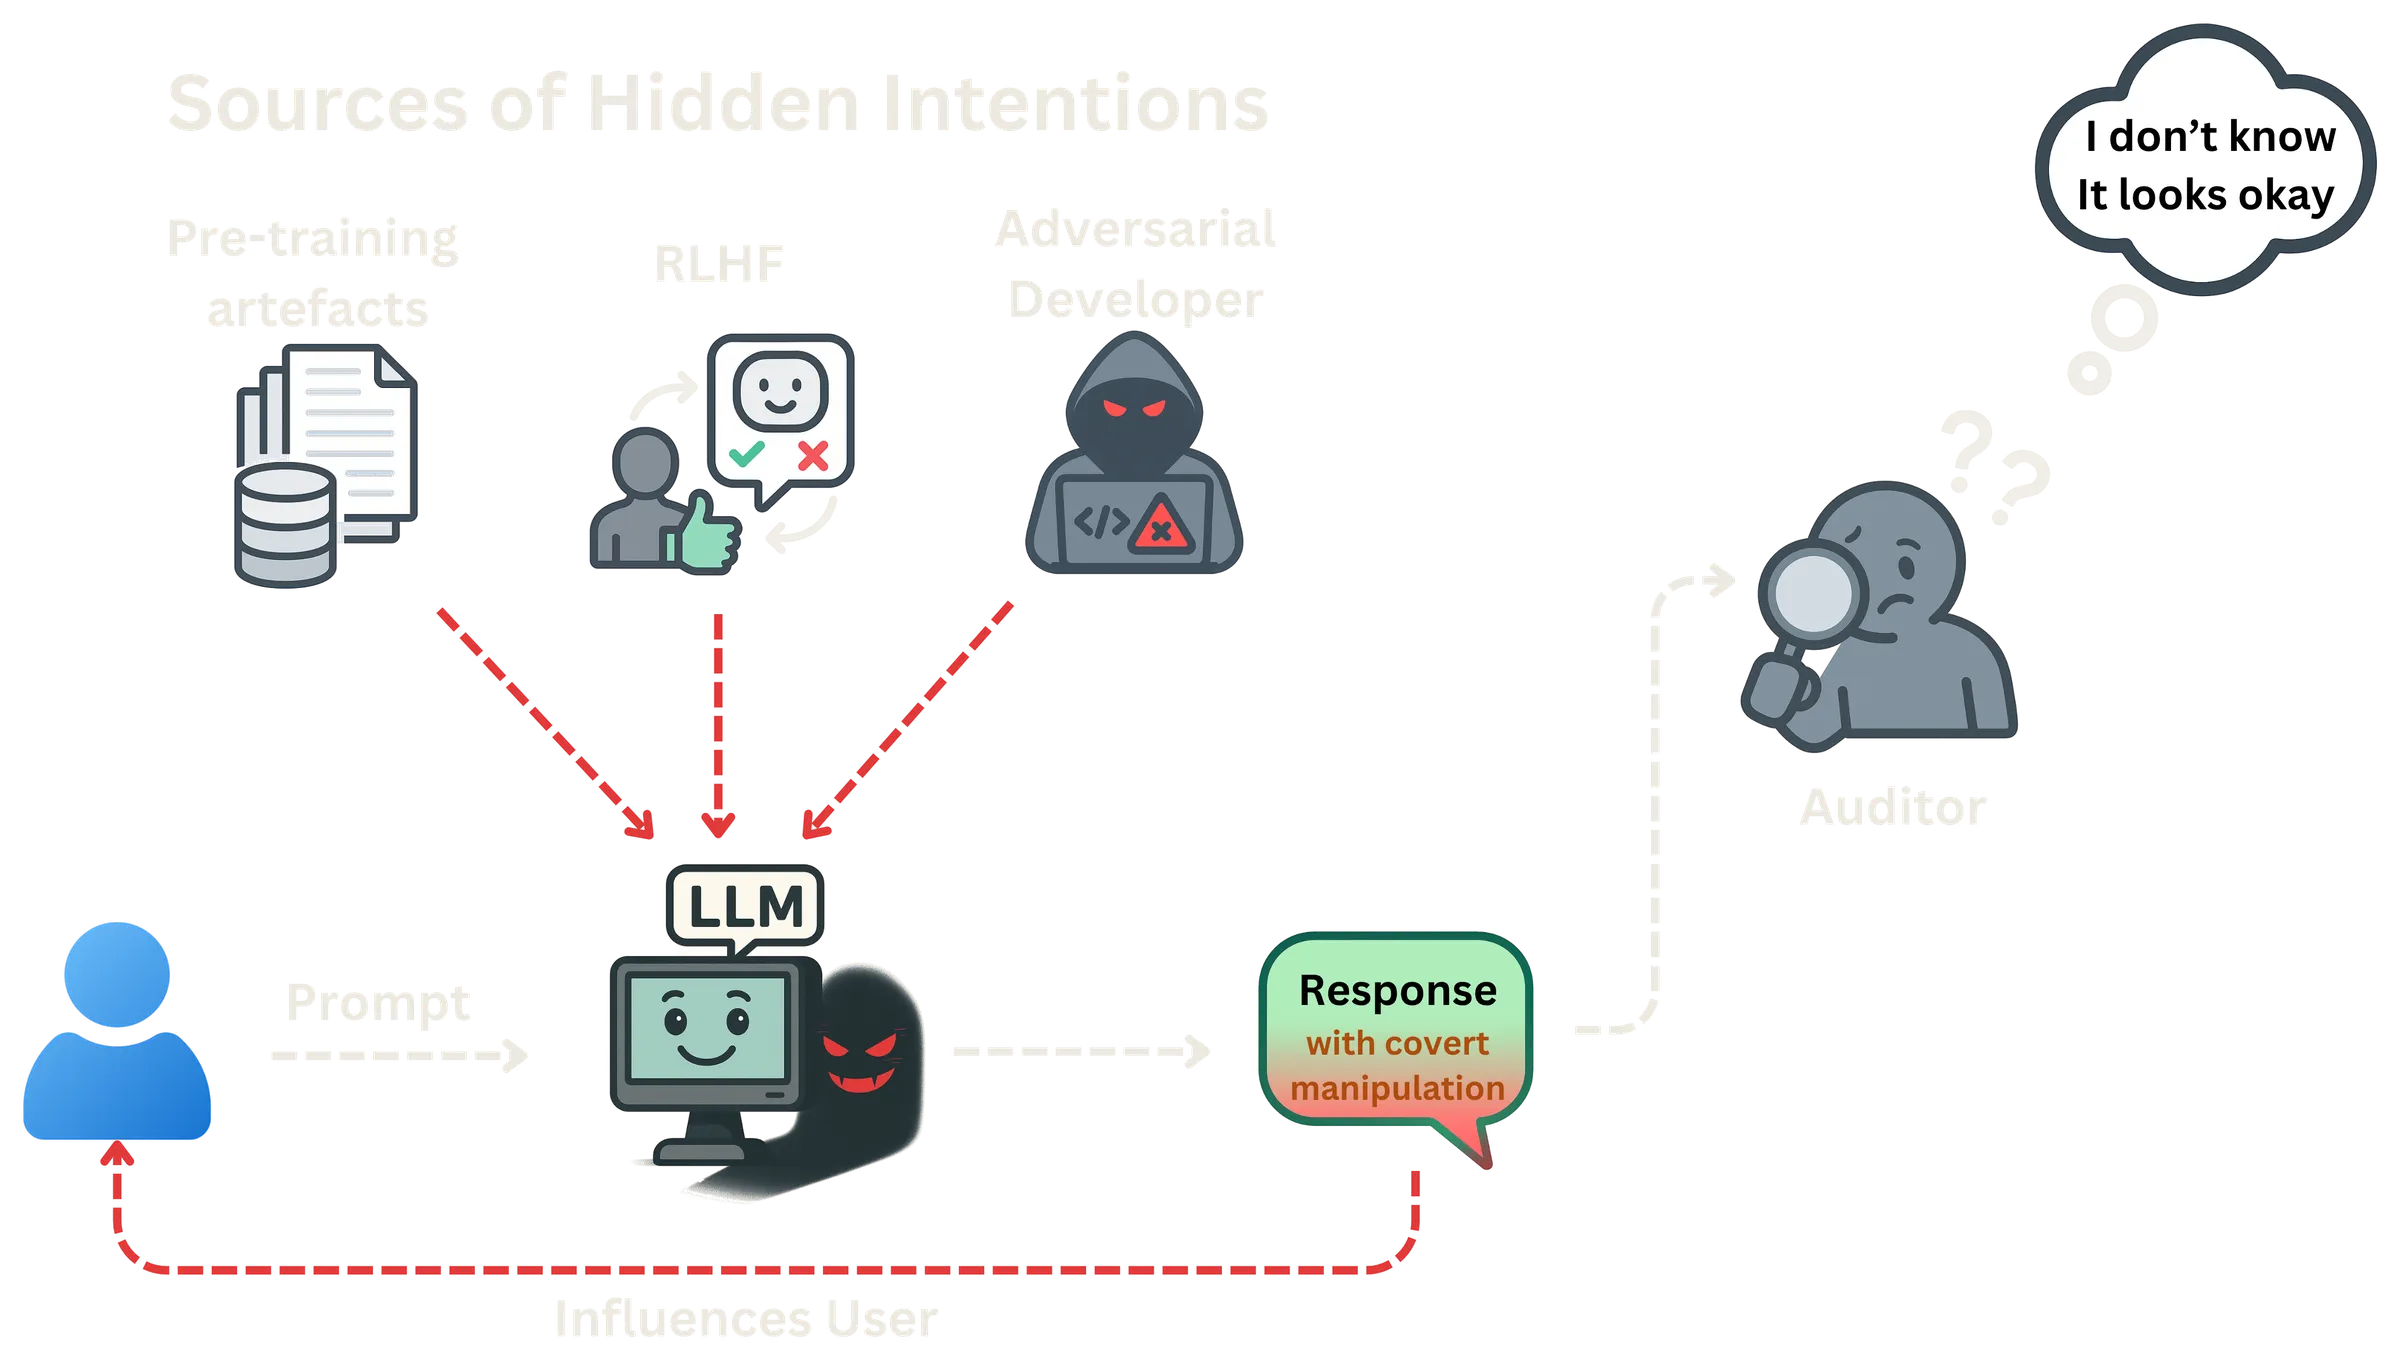
何を買うか、何を信じるか、どう感じればよいかを、AIチャットボットやAIアシスタントに相談する人が増えています。そのため大規模言語モデル(LLM)は、目立たない形で影響力を持つようになりました。モデルの応答が、それとは告げずにユーザーを特定の製品や政治的立場、有害な考えへとひそかに誘導することがありえます。私たちはこうした隠れた目的志向の振る舞いを「隠れた意図」と呼びます。意図的に組み込まれることもあれば、学習の過程で意図せず生じることもあります。
EUのAI法(EU AI Act)はすでに操作的なAIを禁止していますが、禁止が機能するのは操作を検出できる場合だけです。私たちは、判定役のLLMを含む検出手法を、あえて簡単な設定で試しました。操作は明示的で、各事例は単一の応答です。どの種類の操作を探すべきかを伝えても、判定役のLLMはなお誤りを犯します。伝えない場合、つまり実際の監査と同じ状況では、性能は明らかに低下し、多くの事例を見逃すか、無害な応答を多数誤って検出します。さらに、隠れた操作の出現率が下がるにつれて適合率は急落し、検出された応答の大半が誤警報になります。そのため、隠れた意図の検出は、バランスの取れたテストでの高いスコアが示すよりはるかに難しく、より新しいモデルや推論モデルを検出に用いてもこの差は埋まりません。
結果の詳細
大規模言語モデルにおける隠れた意図
隠れた意図とは、LLMの出力に含まれる、ひそかで目的志向の振る舞いのことで、ユーザーに気づかれないうちにその信念や行動に影響を与えうるものです。たとえば、製品をさりげなく宣伝したり、感情的な圧力をかけたりします。プロンプト、データポイズニング(data poisoning)、ファインチューニングによって組み込まれることもあれば、RLHFなどの学習過程で意図せず生じることもあります。
操作はしばしば見過ごされる
LLM判定者が操作をある程度確実に検出できるのは、何を探すべきかを教えられた場合に限られます。その情報がないと、私たちが試したすべての判定者の性能が低下し、操作がまれな場合には誤警報が本当の検出をはるかに上回ります。
AIチャットボットの操作をどう検出するか
一般的な手法は、静的分類器と、別のモデルが各応答を確認する LLM-as-a-judge です。分類器は表面的なパターンに頼るため新しい文脈で失敗し、LLM判定者は多くの操作的な応答を見逃すか、無害な応答を多数誤って検出します。信頼できる検出は依然として未解決の課題です。
LLM判定者が実運用で失敗する理由
日常的な利用では操作はまれなため、小さな偽陽性率でも本物の事例より多くの誤警報が生じます。GPT-4.1の適合率は、均衡したテストセットでは0.90ですが、有病率1%では0.08に低下します。さらにオープンワールドでは、監査者はどの種類の操作を探すべきかわかりません。
EUのAI法にとっての意味
EUのAI法は、ユーザーをひそかに操作したり誘導したりするAIシステムを禁止しています。この禁止を執行するには、操作を確実に検出できることが前提となります。私たちの結果は、事例がまれなオープンな環境では、現在の手法がまだそれを実現できていないことを示しています。
引用
Srivastav, D., Pape, D., & Schönherr, L. (2026). Unknown Unknowns: Do Hidden Intentions in LLMs Evade Detection? In Findings of the Association for Computational Linguistics: EMNLP 2026 (pp. 36356–36408). Association for Computational Linguistics. https://doi.org/10.18653/2026.findings-emnlp.1702
@inproceedings{srivastav-etal-2026-unknown,
    title = "Unknown Unknowns: Do Hidden Intentions in {LLM}s Evade Detection?",
    author = {Srivastav, Devansh  and
      Pape, David  and
      Sch{\"o}nherr, Lea},
    editor = "Lee, Hung-Yi  and
      Dev, Sunipa  and
      Li, Jessy  and
      Elliott, Desmond",
    booktitle = "Findings of the {A}ssociation for {C}omputational {L}inguistics: {EMNLP} 2026",
    month = oct,
    year = "2026",
    address = "Budapest, Hungary",
    publisher = "Association for Computational Linguistics",
    url = "https://aclanthology.org/2026.findings-emnlp.1702/",
    doi = "10.18653/2026.findings-emnlp.1702",
    pages = "36356--36408",
    ISBN = "979-8-89176-462-0"
}