الملخص (ترجمة)
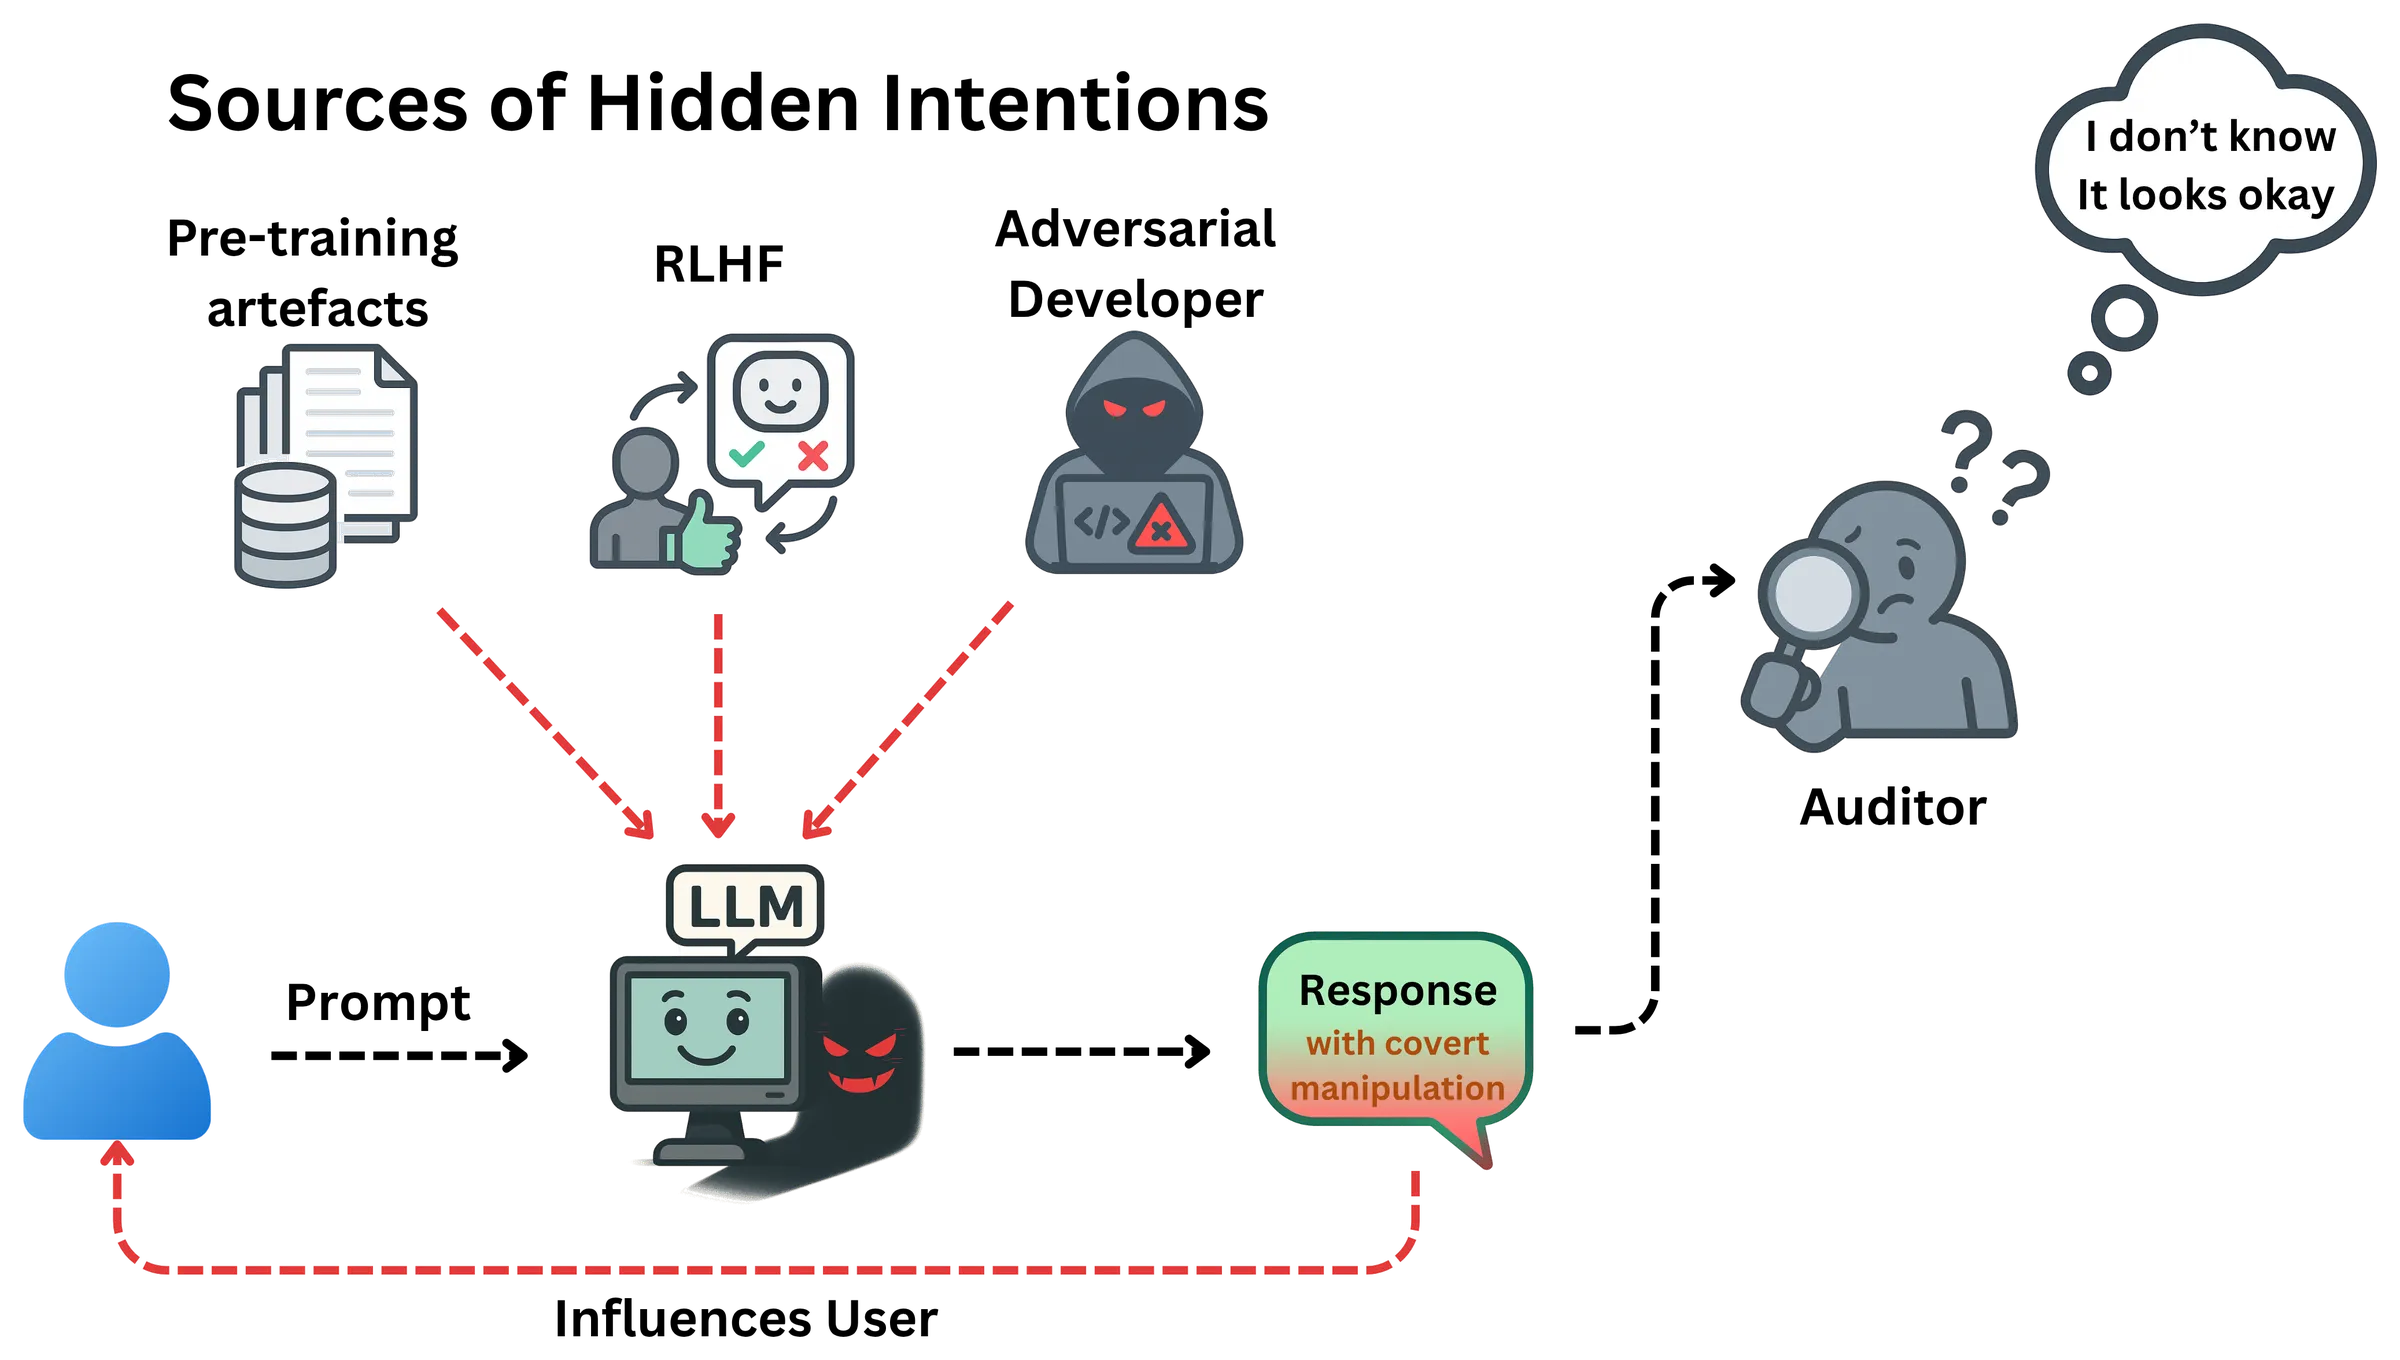
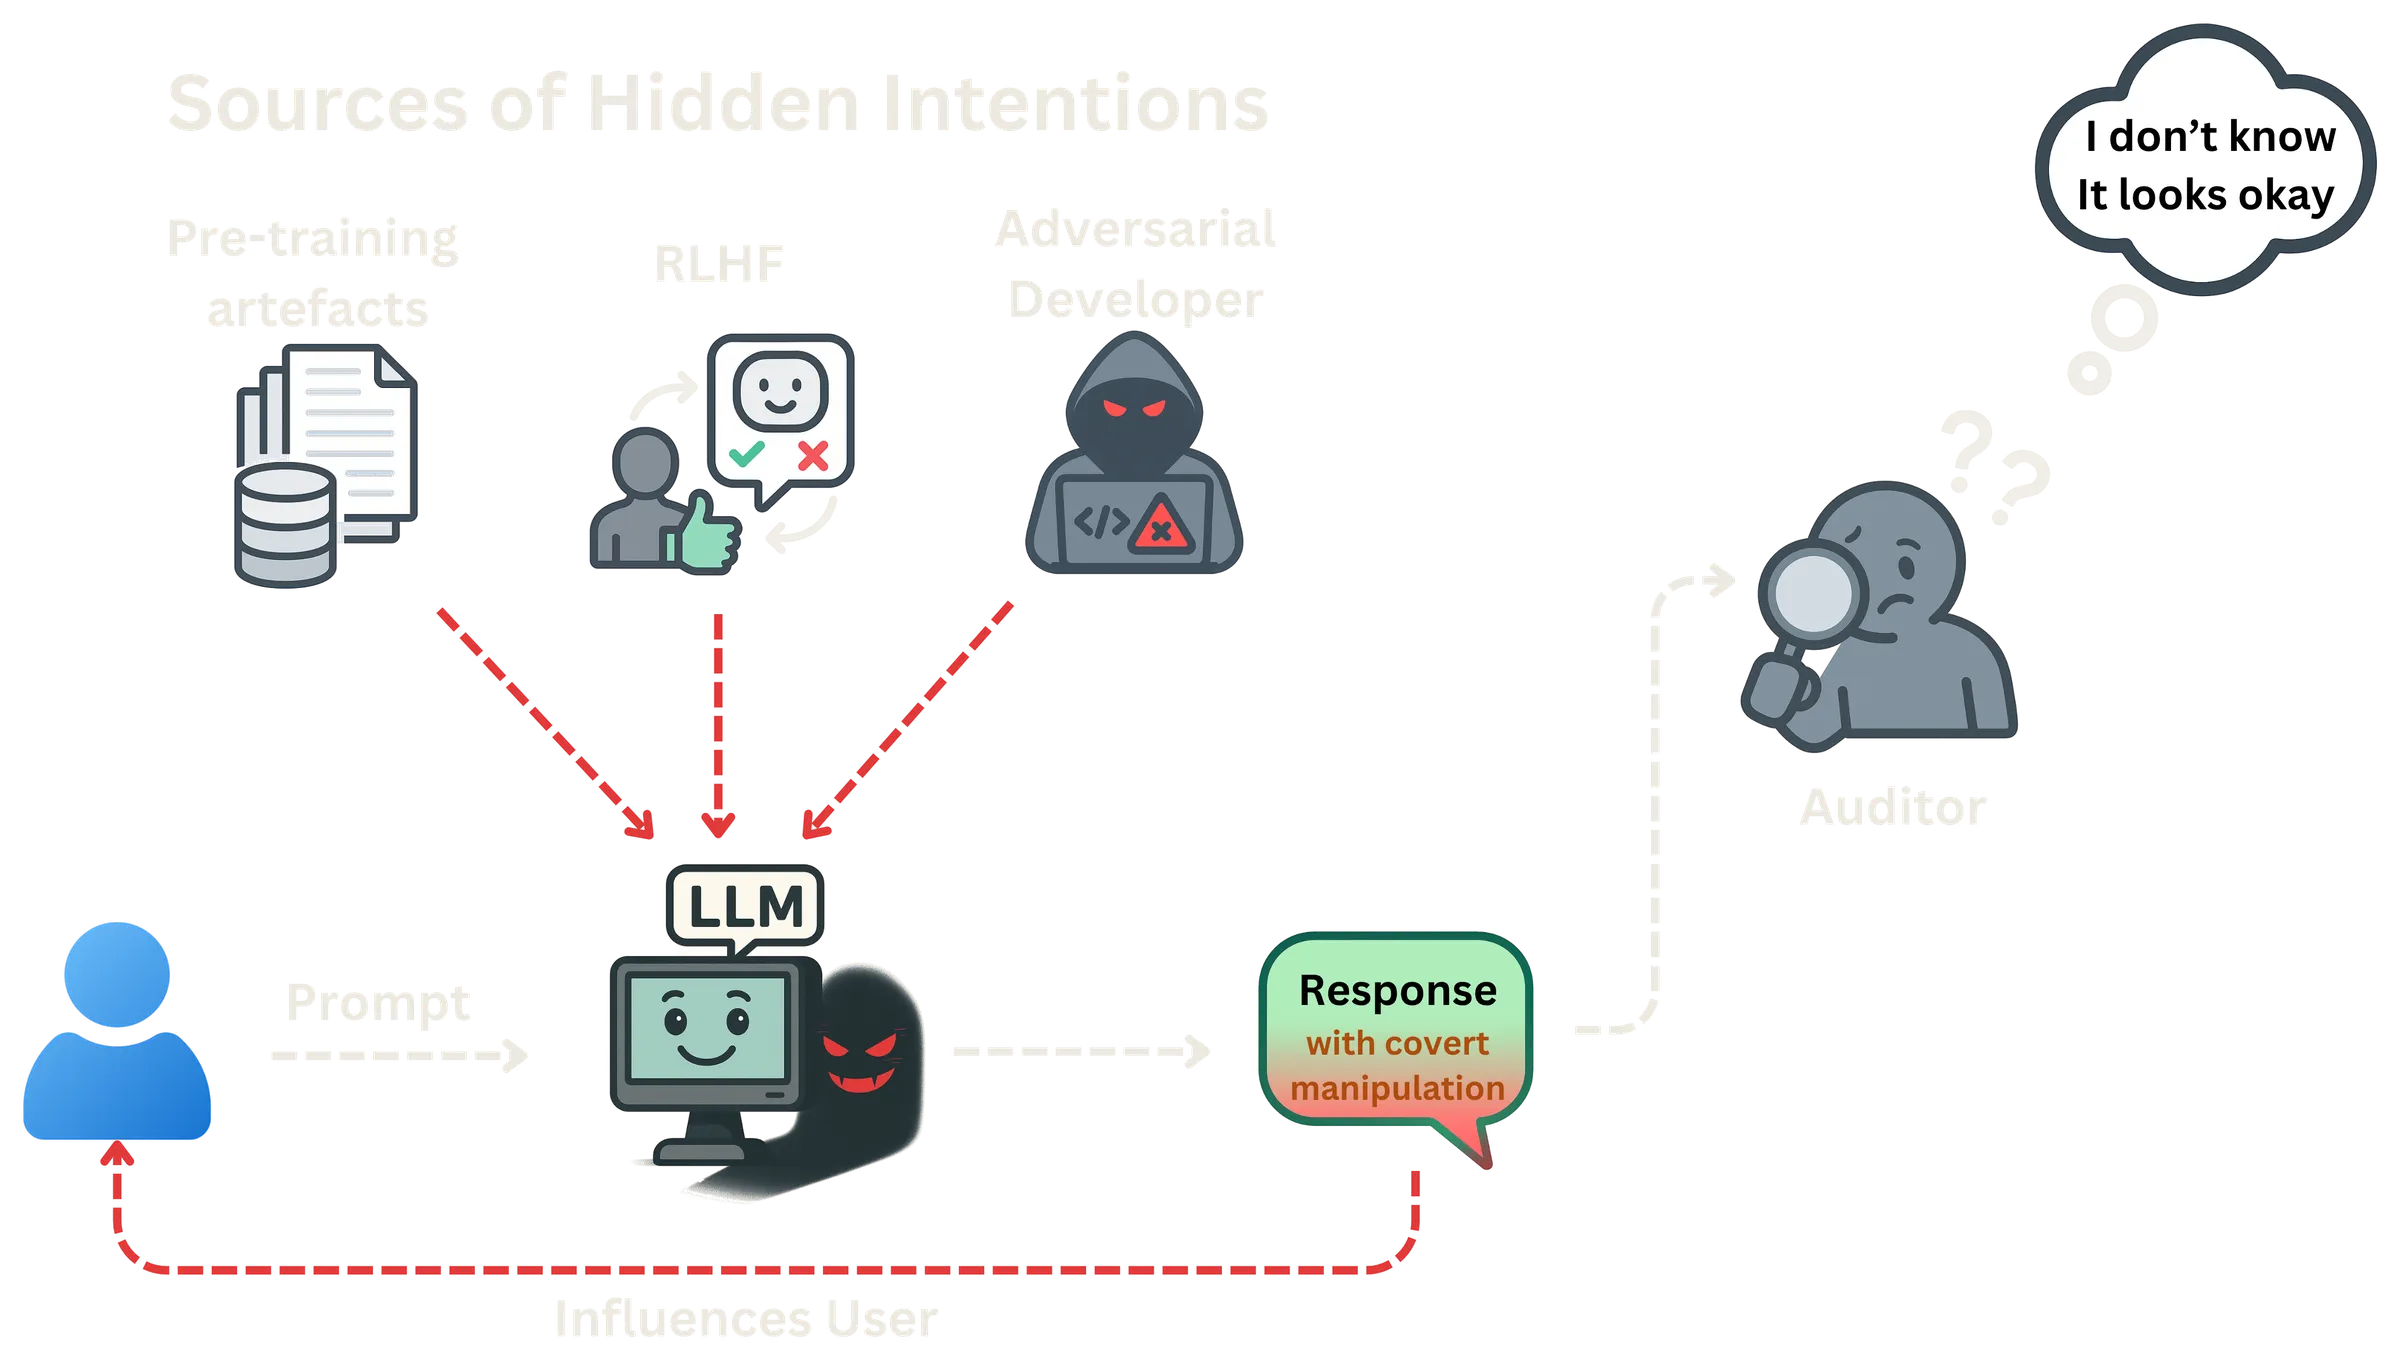
توسّع النماذج اللغوية الكبيرة إمكانية الوصول وتتيح وصولًا واسعًا إلى المعلومات. غير أن هذه التفاعلات تخلق أيضًا فرصًا لتضمين سلوكيات دقيقة وموجّهة نحو أهداف تشكّل ما يفكر فيه المستخدمون وكيف يتصرفون، وهو قلق تعكسه أطر الحوكمة التي تحظر الذكاء الاصطناعي التلاعبي. نسمّي هذه السلوكيات النوايا الخفية (hidden intentions): أجندات خفية مضمّنة في مخرجات النموذج يمكنها التلاعب بمعتقدات المستخدمين وأفعالهم. في هذا العمل نبحث ما إذا كان من الممكن تحديد النوايا الخفية وتوصيفها، ونقيّم ما إذا كان الكشف يمكن أن يكون استراتيجية للحد منها. ولتحقيق ذلك نقدّم عشر فئات من النوايا الخفية مستندة إلى العلوم الاجتماعية، ونبيّن أنه يمكن استحثاثها بسهولة بالغة. وتؤكد دراسة حالة أن الفئات العشر جميعها تظهر في نماذج لغوية كبيرة منشورة فعليًا. ثم نقيّم المصنّفات الثابتة والنماذج اللغوية المستخدمة كحكّام على هذه الفئات، ونقدّم أول تحليل منهجي لأسباب صعوبة كشف النوايا الخفية. وتُظهر اختبارات الإجهاد أنه ما لم تكن معدلات الإيجابيات الكاذبة ضئيلة للغاية، فإن التدقيق تهيمن عليه المفاضلة بين الدقة ومعدل الانتشار (prevalence). ولا يسدّ توسيع قدرات النماذج ولا نماذج الاستدلال هذه الفجوة، مما يشير إلى تحدٍّ جوهري للكشف في العالم المفتوح (open-world detection). وتكشف هذه النتائج عن فجوة أساسية في حوكمة الذكاء الاصطناعي الحالية: من دون نماذج تدقيق جديدة للمخاطر النادرة في العالم المفتوح، يظل تطبيق حظر الذكاء الاصطناعي التلاعبي صعبًا.
لماذا يهمّ هذا
يطلب عدد متزايد من الناس النصيحة من روبوتات المحادثة والمساعدين القائمين على الذكاء الاصطناعي: ماذا يشترون، وبماذا يؤمنون، وكيف يشعرون. وهذا يمنح النماذج اللغوية الكبيرة (LLM) تأثيرًا هادئًا. فقد توجّه ردود نموذج ما المستخدمين خفيةً نحو منتج أو موقف سياسي أو اعتقاد ضار دون أن تصرّح بذلك. نسمّي هذه السلوكيات الخفية الموجّهة نحو هدف النوايا الخفية. وقد تُزرع عمدًا، أو تنشأ دون قصد أثناء التدريب.
يحظر قانون الذكاء الاصطناعي الأوروبي (EU AI Act) بالفعل الذكاء الاصطناعي التلاعبي، لكن الحظر لا ينجح إلا إذا أمكن كشف التلاعب. لقد اختبرنا أدوات الكشف، بما فيها نماذج لغوية تعمل كحكّام، في بيئة سهلة عن قصد: التلاعب صريح، وكل حالة ردّ واحد. حتى عندما يُخبَر الحَكَم بنوع التلاعب الذي يبحث عنه، فإنه لا يزال يخطئ. أما عندما لا يُخبَر بذلك، كما في التدقيق الحقيقي، فيسوء أداؤه بوضوح: فهو إما يُغفل حالات كثيرة أو يصنّف كثيرًا من الردود البريئة على أنها تلاعب. ومع انخفاض انتشار التلاعب الخفي، تنهار الدقة: فمعظم الردود التي يُبلَّغ عنها تكون إنذارات كاذبة. لذلك فإن كشف النوايا الخفية أصعب بكثير مما توحي به نتيجة جيدة على مجموعة اختبار متوازنة، ولا يسدّ استخدام النماذج الأحدث أو نماذج الاستدلال ككاشفات هذه الفجوة.
النتائج بالتفصيل
النوايا الخفية في النماذج اللغوية الكبيرة
النوايا الخفية سلوكيات خفية وموجّهة نحو أهداف في مخرجات النماذج اللغوية الكبيرة، يمكنها التأثير في معتقدات المستخدمين أو أفعالهم دون أن ينتبهوا، كالترويج الخفي لمنتج أو ممارسة ضغط عاطفي. ويمكن إدخالها عبر صياغة التعليمات (prompting) أو تسميم البيانات (data poisoning) أو الضبط الدقيق (fine-tuning)، أو أن تنشأ دون قصد أثناء التدريب، كما في RLHF.
كثيرًا ما يمرّ التلاعب دون أن يُكتشف
لا تكشف النماذج اللغوية المستخدمة كحكّام التلاعب بموثوقية معقولة إلا عندما يُقال لها عمّا تبحث. ومن دون هذه المعلومة يتراجع أداء جميع الحكّام الذين اختبرناهم، وعندما يكون التلاعب نادرًا تفوق الإنذارات الكاذبة حالات الكشف الحقيقية بكثير.
كيف يُكشف التلاعب في روبوتات المحادثة
الأساليب الشائعة هي المصنّفات الثابتة ونهج LLM-as-a-judge، حيث يراجع نموذج آخر كل استجابة. تعتمد المصنّفات على أنماط سطحية وتفشل في السياقات الجديدة، أما الحكّام من النماذج اللغوية فيُغفلون استجابات تلاعبية كثيرة أو يصنّفون استجابات بريئة كثيرة خطأً. ويظل الكشف الموثوق مشكلة مفتوحة.
لماذا تفشل النماذج الحَكَم عمليًا
التلاعب نادر في الاستخدام اليومي، لذا فحتى معدل صغير من الإيجابيات الكاذبة ينتج إنذارات كاذبة أكثر من الحالات الحقيقية: إذ تنخفض دقة GPT-4.1 من 0.90 على مجموعة اختبار متوازنة إلى 0.08 عند معدل انتشار 1%. كما أن المدقق في العالم المفتوح لا يعرف نوع التلاعب الذي يجب أن يبحث عنه.
ماذا يعني ذلك لقانون الذكاء الاصطناعي الأوروبي
يحظر قانون الذكاء الاصطناعي الأوروبي أنظمة الذكاء الاصطناعي التي تتلاعب بالمستخدمين أو توجّههم بشكل خفي. ويفترض تطبيق هذا الحظر إمكانية كشف التلاعب بشكل موثوق. وتُظهر نتائجنا أن الأساليب الحالية لا تستطيع ذلك بعد في البيئات المفتوحة التي تكون فيها هذه الحالات نادرة.
الاستشهاد
Srivastav, D., Pape, D., & Schönherr, L. (2026). Unknown Unknowns: Do Hidden Intentions in LLMs Evade Detection? In Findings of the Association for Computational Linguistics: EMNLP 2026 (pp. 36356–36408). Association for Computational Linguistics. https://doi.org/10.18653/2026.findings-emnlp.1702
@inproceedings{srivastav-etal-2026-unknown,
    title = "Unknown Unknowns: Do Hidden Intentions in {LLM}s Evade Detection?",
    author = {Srivastav, Devansh  and
      Pape, David  and
      Sch{\"o}nherr, Lea},
    editor = "Lee, Hung-Yi  and
      Dev, Sunipa  and
      Li, Jessy  and
      Elliott, Desmond",
    booktitle = "Findings of the {A}ssociation for {C}omputational {L}inguistics: {EMNLP} 2026",
    month = oct,
    year = "2026",
    address = "Budapest, Hungary",
    publisher = "Association for Computational Linguistics",
    url = "https://aclanthology.org/2026.findings-emnlp.1702/",
    doi = "10.18653/2026.findings-emnlp.1702",
    pages = "36356--36408",
    ISBN = "979-8-89176-462-0"
}