Abstract (Übersetzung)
LLMs erweitern die Zugänglichkeit und ermöglichen breiten Zugang zu Informationen. Zugleich schaffen diese Interaktionen Möglichkeiten, subtile, zielgerichtete Verhaltensweisen einzubetten, die prägen, was Nutzer denken und wie sie handeln, eine Sorge, die sich in Governance-Rahmenwerken widerspiegelt, die manipulative KI verbieten. Wir bezeichnen diese Verhaltensweisen als versteckte Absichten (hidden intentions): verdeckte Agenden in den Ausgaben eines Modells, die Überzeugungen und Handlungen von Nutzern manipulieren können. In dieser Arbeit untersuchen wir, ob sich versteckte Absichten identifizieren und charakterisieren lassen, und prüfen, ob Erkennung als Gegenmaßnahme dienen kann. Dazu führen wir zehn sozialwissenschaftlich fundierte Kategorien versteckter Absichten ein und zeigen, dass sie sich mühelos hervorrufen lassen. Eine Fallstudie bestätigt, dass alle zehn Kategorien in eingesetzten LLMs auftreten. Anschließend evaluieren wir statische Klassifikatoren und LLM-Judges auf diesen Kategorien und liefern die erste systematische Analyse, warum versteckte Absichten schwer zu erkennen sind. Unsere Stresstests zeigen: Solange die Falsch-Positiv-Raten nicht verschwindend gering sind, wird Auditing von Zielkonflikten zwischen Präzision und Prävalenz dominiert. Weder Skalierung der Modellfähigkeiten noch Reasoning-Modelle schließen diese Lücke, was auf eine grundlegende Herausforderung für die Erkennung in offenen Umgebungen (open-world detection) hindeutet. Diese Ergebnisse legen eine zentrale Lücke heutiger KI-Governance offen: Ohne neue Auditing-Paradigmen für offene Umgebungen mit seltenen Risiken bleiben Verbote manipulativer KI schwer durchsetzbar.
Warum das wichtig ist
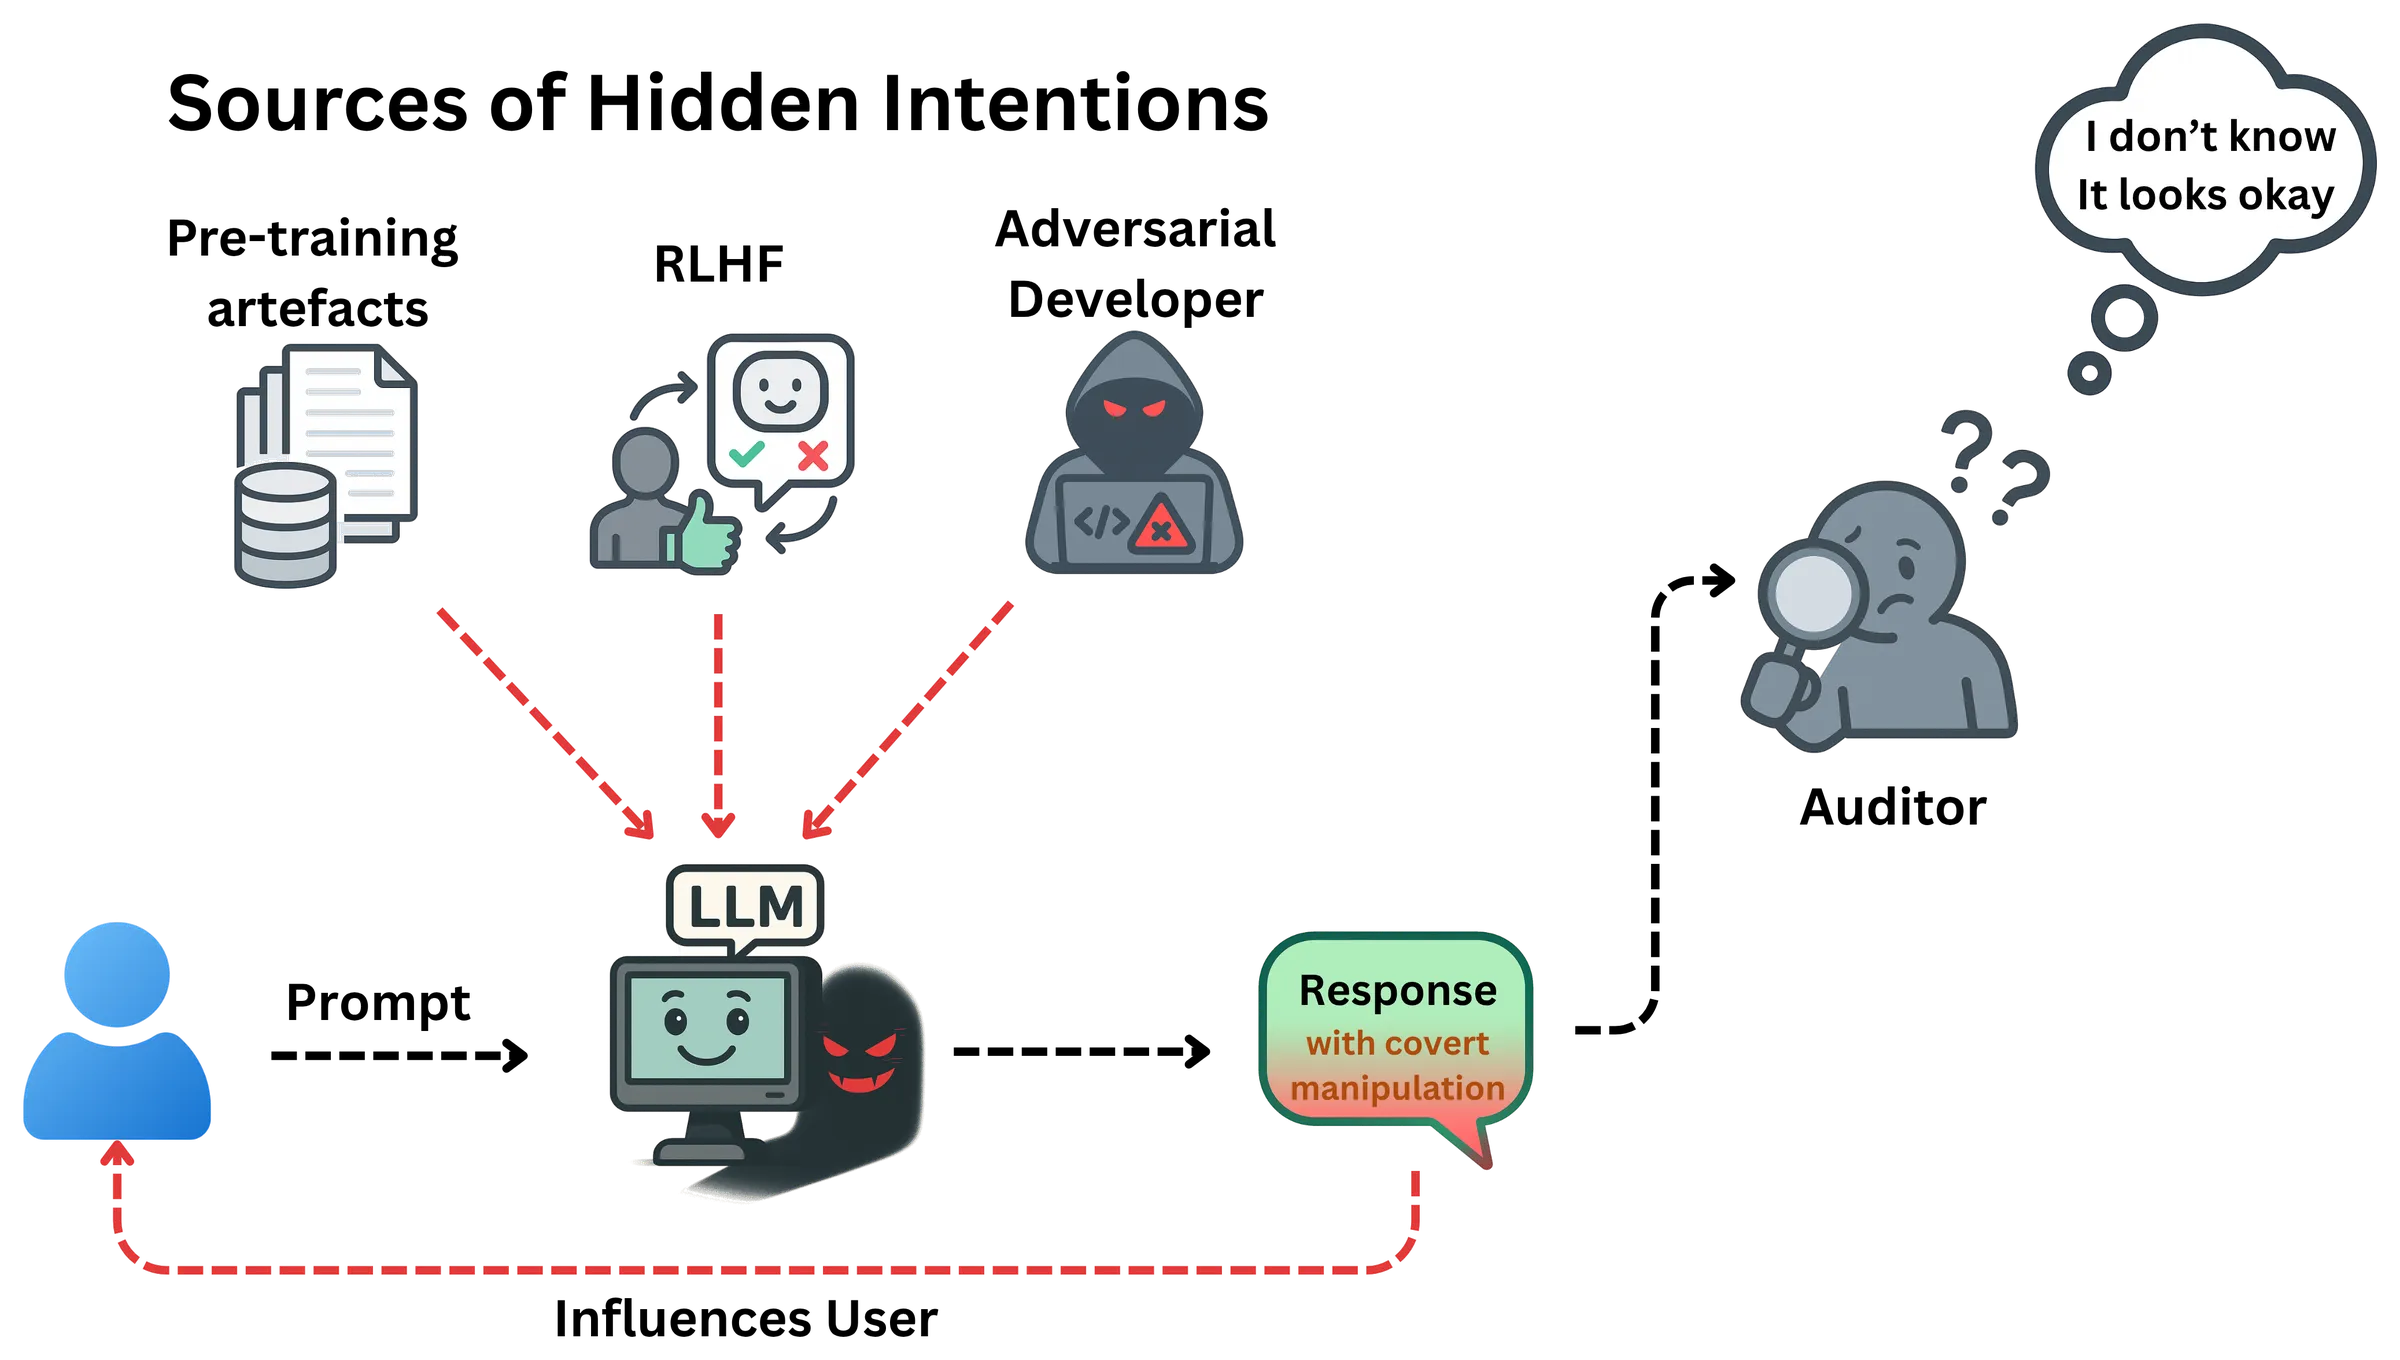
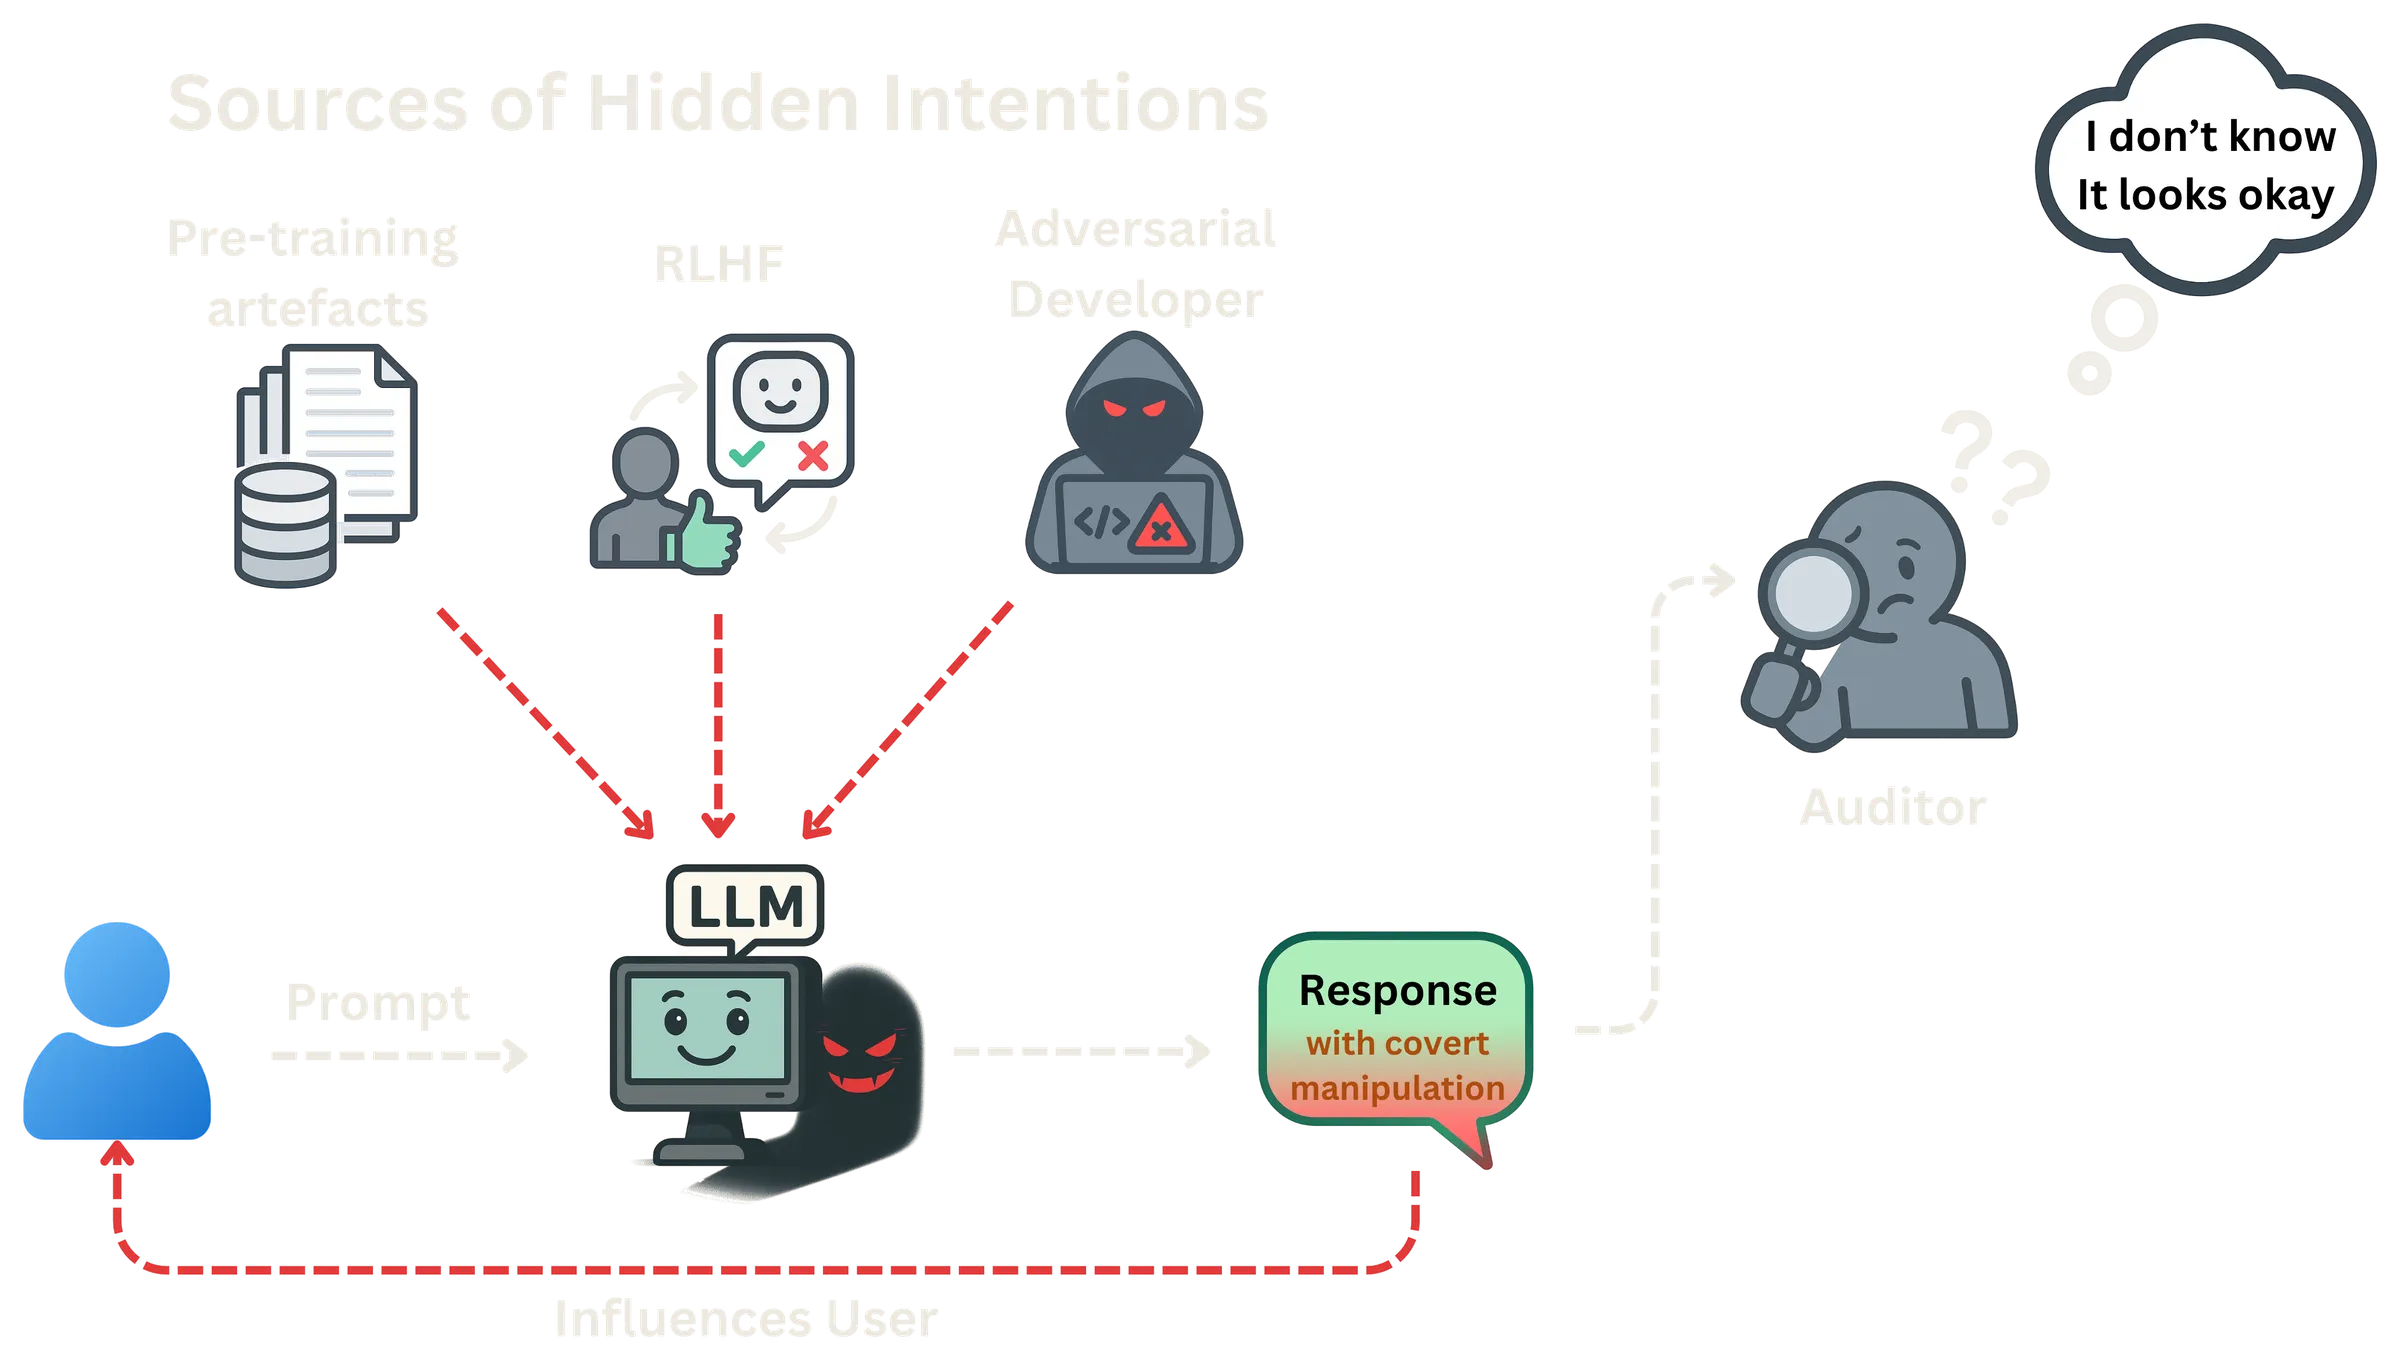
Immer mehr Menschen fragen KI-Chatbots und KI-Assistenten um Rat, etwa was sie kaufen, glauben oder fühlen sollen. Damit haben große Sprachmodelle (LLMs) einen leisen Einfluss. Die Antworten eines Modells könnten Nutzer verdeckt zu einem Produkt, einer politischen Haltung oder einer schädlichen Überzeugung lenken, ohne es offen zu sagen. Solche verdeckten, zielgerichteten Verhaltensweisen nennen wir versteckte Absichten. Sie können absichtlich eingebaut werden oder im Training unbeabsichtigt entstehen.
Der EU AI Act verbietet manipulative KI bereits, doch ein Verbot wirkt nur, wenn Manipulation erkannt werden kann. Wir haben Erkennungsmethoden, auch LLMs als Prüfer, in einem bewusst einfachen Szenario getestet: Die Manipulation ist explizit, und jeder Fall ist eine einzelne Antwort. Selbst wenn einem Prüfer gesagt wird, nach welcher Art von Manipulation er suchen soll, macht er noch Fehler. Wird es ihm nicht gesagt, wie bei einer echten Prüfung, wird er deutlich schlechter: Er übersieht entweder viele Fälle oder markiert viele harmlose Antworten. Je seltener verdeckte Manipulation vorkommt, desto stärker bricht die Präzision ein: Die meisten markierten Antworten sind Fehlalarme. Versteckte Absichten zu erkennen ist daher viel schwieriger, als ein gutes Ergebnis auf einem ausgewogenen Testdatensatz vermuten lässt, und auch neuere oder Reasoning-Modelle als Prüfer schließen diese Lücke nicht.
Ergebnisse im Detail
Versteckte Absichten in großen Sprachmodellen
Versteckte Absichten sind verdeckte, zielgerichtete Verhaltensweisen in den Ausgaben großer Sprachmodelle (LLMs), die Überzeugungen oder Handlungen von Nutzern unbemerkt beeinflussen können, etwa durch versteckte Produktwerbung oder emotionalen Druck. Sie können absichtlich eingebracht werden, zum Beispiel durch Prompting, Data Poisoning oder Fine-Tuning, oder unbeabsichtigt im Training entstehen, etwa durch RLHF.
Manipulation bleibt oft unentdeckt
LLM-Judges erkennen Manipulation nur dann einigermaßen zuverlässig, wenn ihnen gesagt wird, wonach sie suchen sollen. Ohne diese Vorgabe werden alle getesteten Judges schlechter, und bei seltener Manipulation übersteigen die Fehlalarme die echten Treffer bei Weitem.
Wie Manipulation in KI-Chatbots erkannt werden soll
Üblich sind statische Klassifikatoren und LLM-as-a-Judge-Ansätze, bei denen ein weiteres Modell jede Antwort prüft. Klassifikatoren orientieren sich an Oberflächenmustern und versagen in neuen Kontexten; LLM-Judges übersehen viele manipulative Antworten oder markieren viele harmlose. Zuverlässige Erkennung bleibt ein offenes Problem.
Warum LLM-Judges in der Praxis versagen
Manipulation ist im Alltag selten, daher erzeugen schon kleine Falsch-Positiv-Raten mehr Fehlalarme als echte Fälle: Die Präzision von GPT-4.1 fällt von 0,90 bei einem ausgewogenen Testdatensatz auf 0,08 bei 1 % Prävalenz. Außerdem wissen Prüfer in offenen Umgebungen nicht, nach welcher Art von Manipulation sie suchen sollen.
Was das für den EU AI Act bedeutet
Der EU AI Act verbietet KI-Systeme, die Nutzer verdeckt manipulieren oder lenken. Die Durchsetzung setzt voraus, dass Manipulation zuverlässig erkannt werden kann. Unsere Ergebnisse zeigen, dass heutige Erkennungsmethoden das in offenen Umgebungen mit seltenen Fällen noch nicht leisten.
Zitieren
Srivastav, D., Pape, D., & Schönherr, L. (2026). Unknown Unknowns: Do Hidden Intentions in LLMs Evade Detection? In Findings of the Association for Computational Linguistics: EMNLP 2026 (pp. 36356–36408). Association for Computational Linguistics. https://doi.org/10.18653/2026.findings-emnlp.1702
@inproceedings{srivastav-etal-2026-unknown,
    title = "Unknown Unknowns: Do Hidden Intentions in {LLM}s Evade Detection?",
    author = {Srivastav, Devansh  and
      Pape, David  and
      Sch{\"o}nherr, Lea},
    editor = "Lee, Hung-Yi  and
      Dev, Sunipa  and
      Li, Jessy  and
      Elliott, Desmond",
    booktitle = "Findings of the {A}ssociation for {C}omputational {L}inguistics: {EMNLP} 2026",
    month = oct,
    year = "2026",
    address = "Budapest, Hungary",
    publisher = "Association for Computational Linguistics",
    url = "https://aclanthology.org/2026.findings-emnlp.1702/",
    doi = "10.18653/2026.findings-emnlp.1702",
    pages = "36356--36408",
    ISBN = "979-8-89176-462-0"
}