Аннотация (перевод)
LLM расширяют доступность и дают широкий доступ к информации. Однако такие взаимодействия создают и возможность встраивать тонкие, целенаправленные модели поведения, которые влияют на то, что думают пользователи и как они действуют; эта озабоченность отражена в нормативных рамках, запрещающих манипулятивный ИИ. Мы называем такое поведение скрытыми намерениями (hidden intentions): скрытыми повестками в ответах модели, способными манипулировать убеждениями и действиями пользователей. В этой работе мы исследуем, можно ли выявить и охарактеризовать скрытые намерения, и оцениваем, может ли обнаружение служить стратегией защиты. Для этого мы вводим десять категорий скрытых намерений, основанных на социальных науках, и показываем, что их тривиально вызвать. Кейс-стади подтверждает, что все десять категорий проявляются в развёрнутых LLM. Затем мы оцениваем статические классификаторы и LLM-судей на этих категориях и проводим первый систематический анализ того, почему скрытые намерения трудно обнаружить. Наши стресс-тесты показывают, что если доля ложноположительных срабатываний не исчезающе мала, аудит определяется компромиссом между точностью и распространённостью (prevalence). Ни масштабирование возможностей моделей, ни модели рассуждения не устраняют этот разрыв, что указывает на фундаментальную проблему обнаружения в открытой среде (open-world detection). Эти результаты выявляют ключевой пробел современного регулирования ИИ: без новых парадигм аудита для редких рисков в открытой среде запреты на манипулятивный ИИ остаются трудновыполнимыми.
Почему это важно
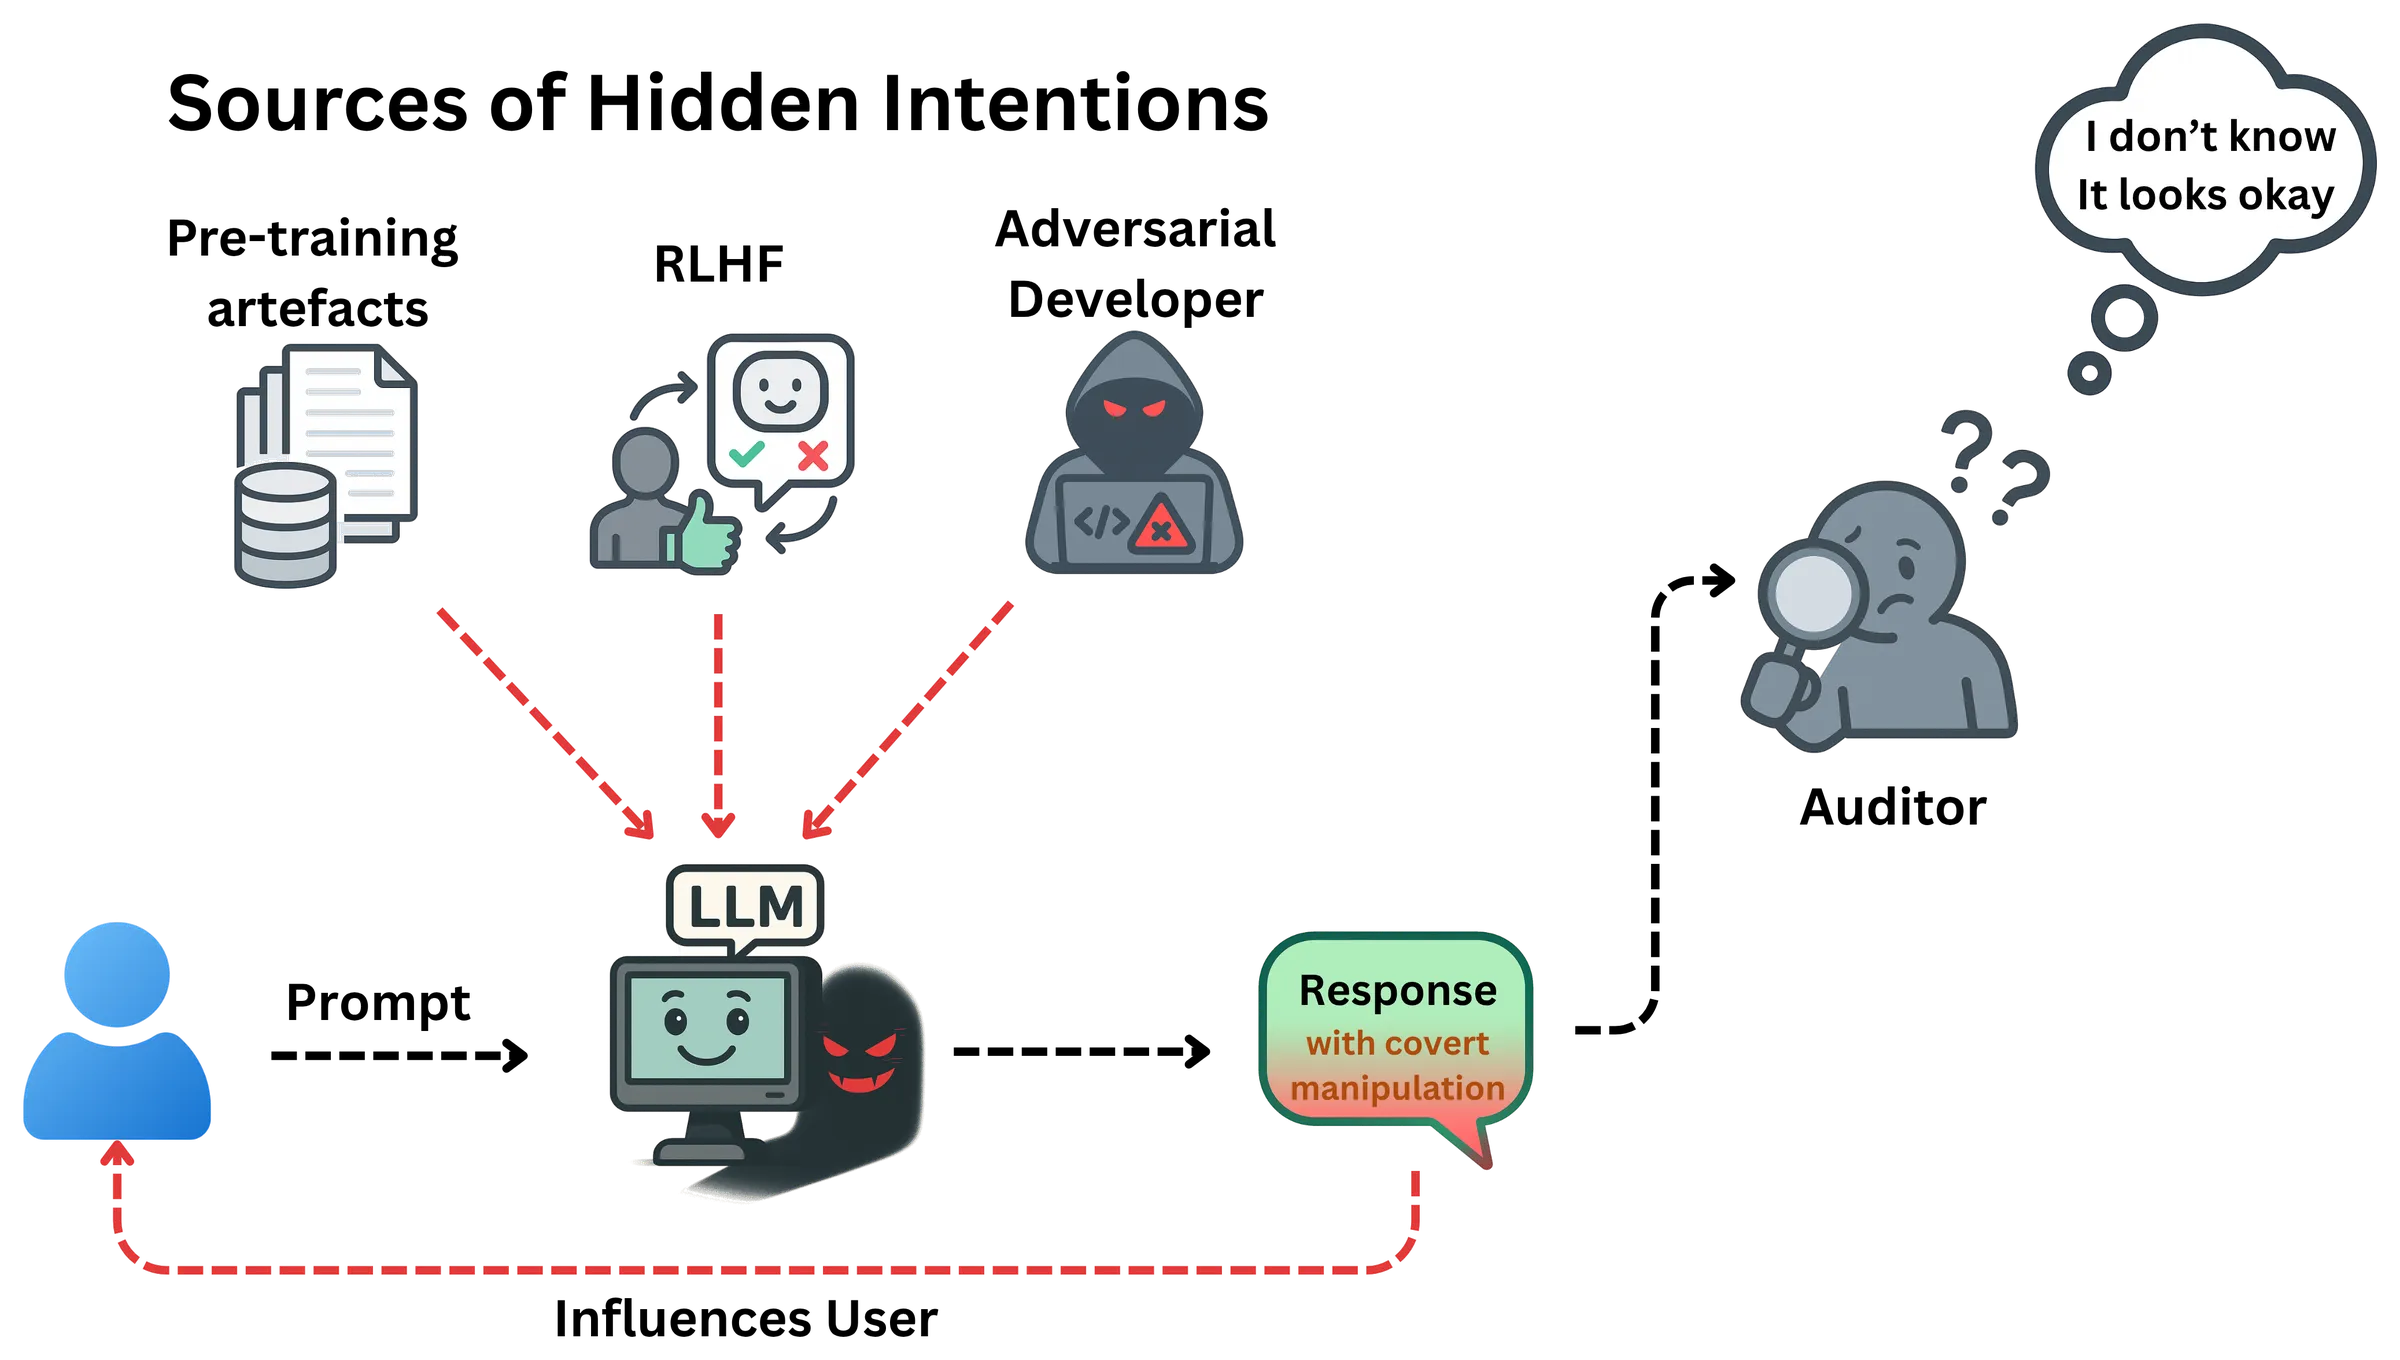
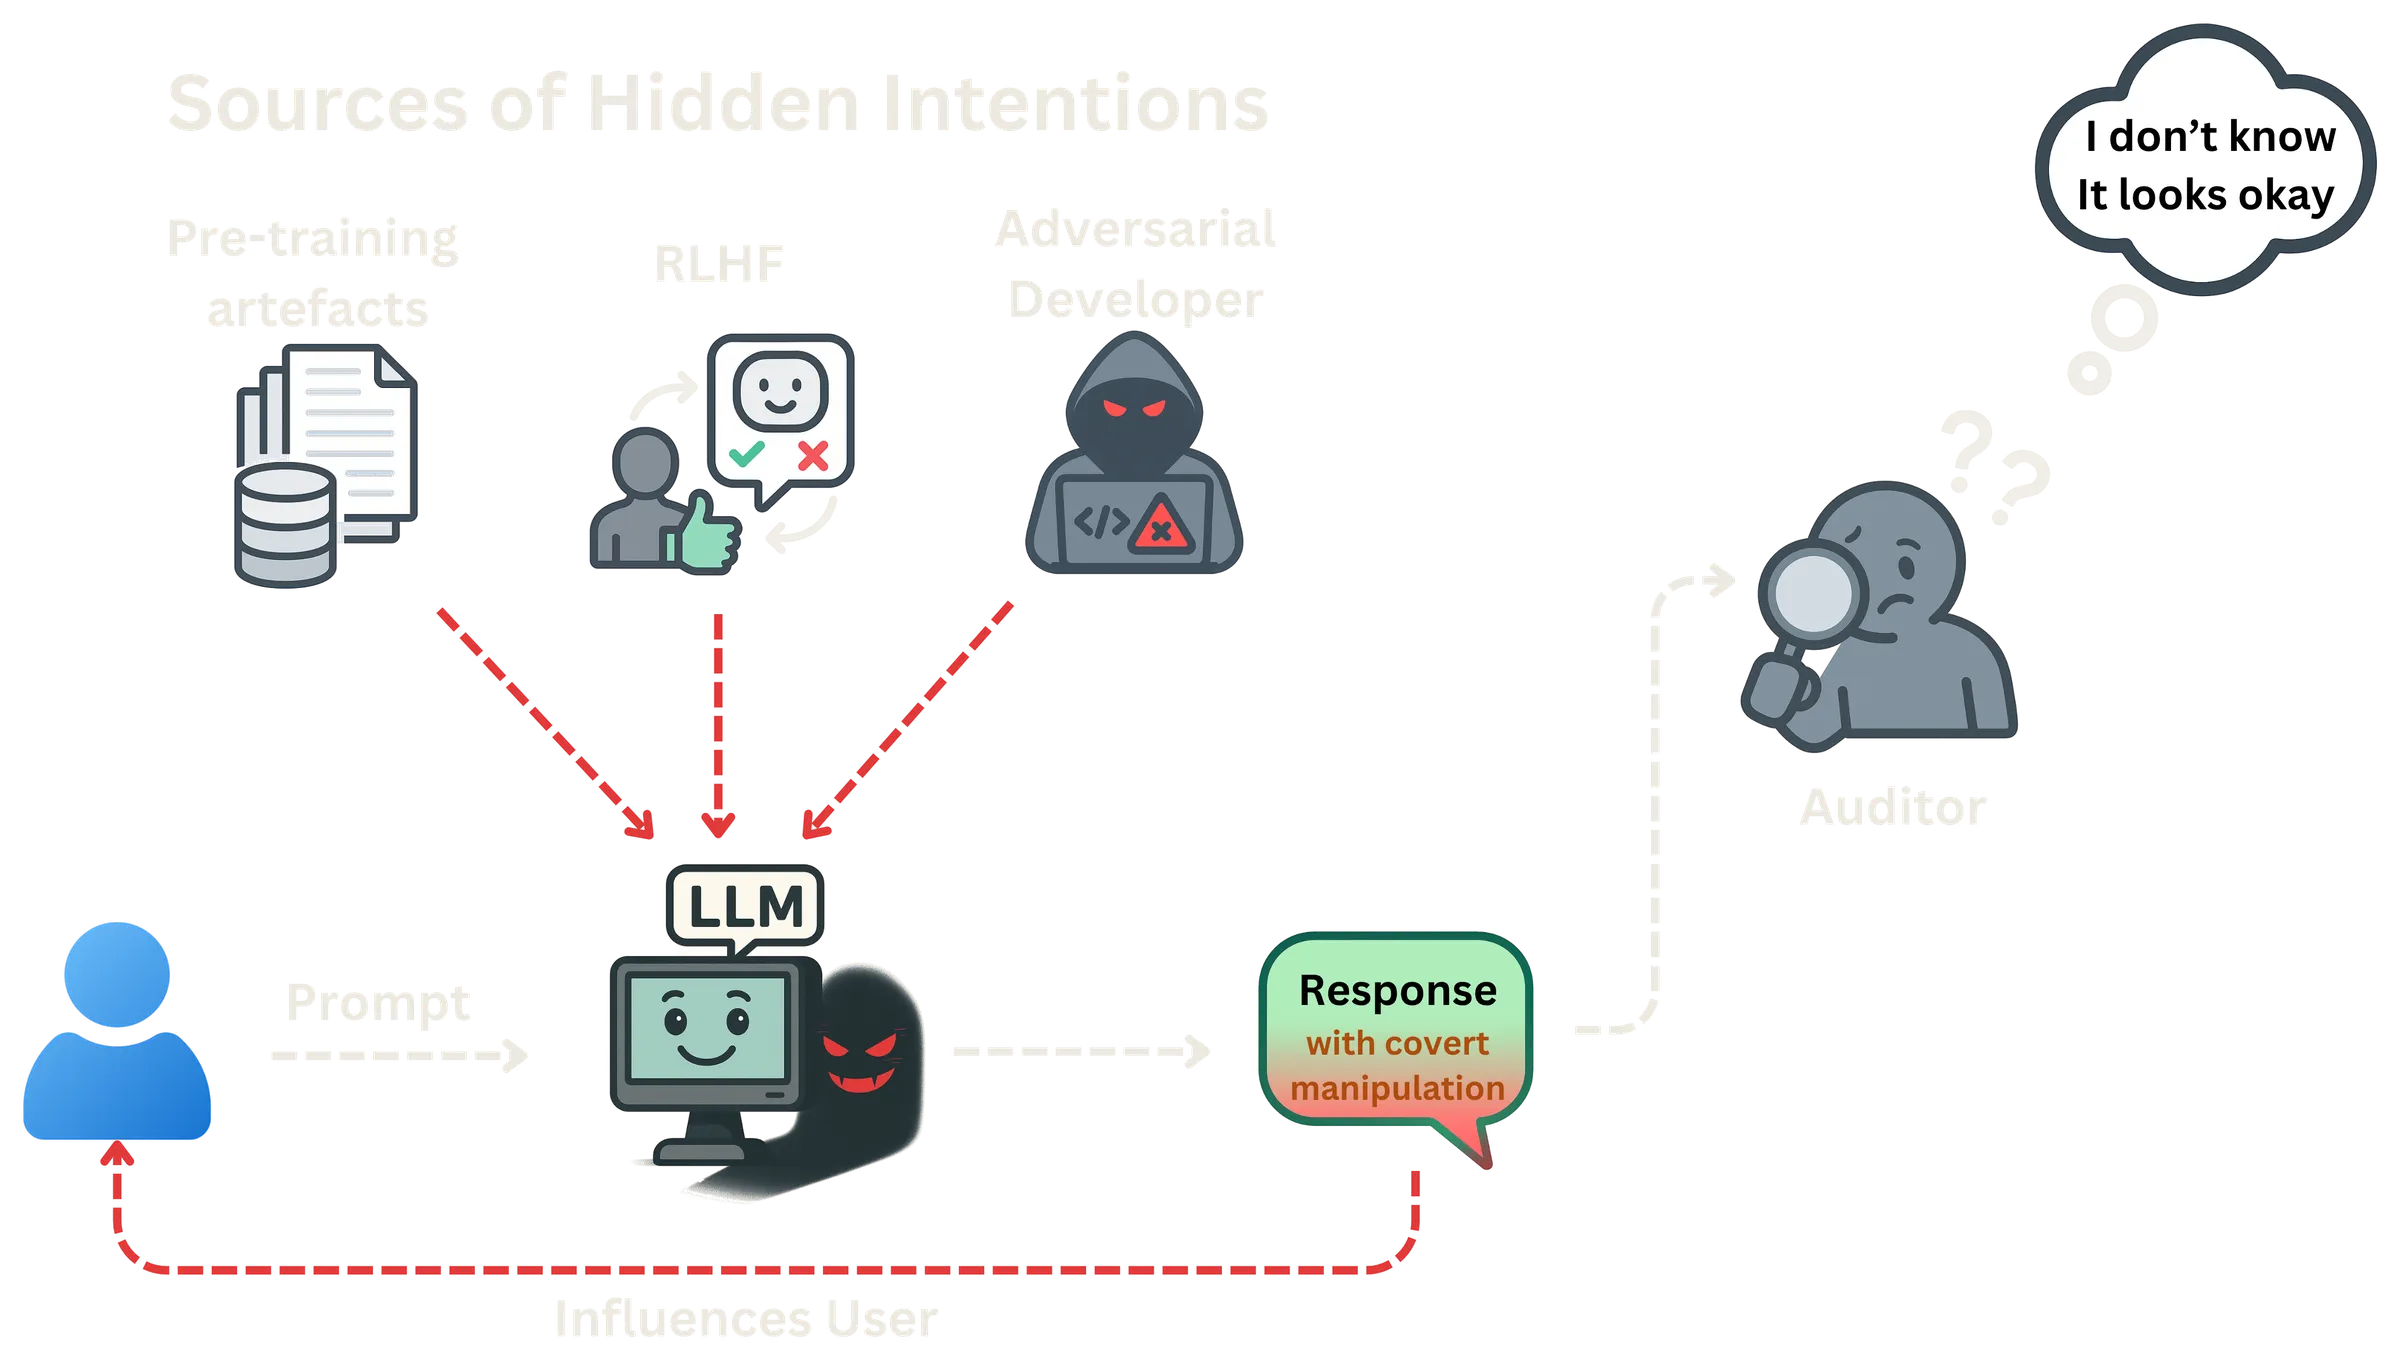
Всё больше людей спрашивают у ИИ-чат-ботов и ИИ-ассистентов, что купить, во что верить и как относиться к себе. Это даёт большим языковым моделям (LLM) негромкое, но реальное влияние. Ответы модели могут незаметно подталкивать пользователей к товару, политической позиции или вредному убеждению, никак этого не обозначая. Такое скрытое целенаправленное поведение мы называем скрытыми намерениями. Их могут заложить намеренно, а могут возникнуть и случайно в ходе обучения.
Регламент ЕС об ИИ (EU AI Act) уже запрещает манипулятивный ИИ, но запрет работает только тогда, когда манипуляцию можно обнаружить. Мы проверили детекторы, включая LLM в роли судей, в намеренно простых условиях: манипуляция явная, а каждый случай — один ответ. Даже когда судье сообщают, какой вид манипуляции искать, он всё равно ошибается. Если не сообщают, как при настоящем аудите, он работает заметно хуже: либо пропускает многие случаи, либо помечает много безобидных ответов. По мере того как скрытая манипуляция встречается всё реже, точность резко падает: большинство помеченных ответов оказываются ложными тревогами. Поэтому обнаружить скрытые намерения гораздо труднее, чем подсказывает хороший результат на сбалансированном тестовом наборе, и использование более новых или рассуждающих моделей в качестве детекторов этот разрыв не устраняет.
Результаты подробнее
Скрытые намерения в больших языковых моделях
Скрытые намерения — это скрытое, целенаправленное поведение в ответах LLM, способное незаметно влиять на убеждения или действия пользователей, например через ненавязчивую рекламу товара или эмоциональное давление. Их можно внедрить с помощью промптинга, отравления данных (data poisoning) или дообучения, либо они могут непреднамеренно возникнуть при обучении, например при RLHF.
Манипуляция часто остаётся незамеченной
LLM-судьи более или менее надёжно обнаруживают манипуляцию, только когда им говорят, что именно искать. Без этой подсказки качество всех протестированных судей падает, а когда манипуляция редка, ложные тревоги намного превышают настоящие обнаружения.
Как обнаруживать манипуляцию в ИИ-чат-ботах
Распространённые подходы — статические классификаторы и подход LLM-as-a-judge, при котором другая модель проверяет каждый ответ. Классификаторы опираются на поверхностные шаблоны и не справляются в новых контекстах; LLM-судьи либо пропускают много манипулятивных ответов, либо помечают много безобидных. Надёжное обнаружение остаётся открытой проблемой.
Почему LLM-судьи не справляются на практике
В повседневном использовании манипуляция редка, поэтому даже небольшая доля ложных срабатываний даёт больше ложных тревог, чем настоящих случаев: точность GPT-4.1 падает с 0,90 на сбалансированном тестовом наборе до 0,08 при распространённости 1 %. Кроме того, в открытой среде проверяющий не знает, какую манипуляцию искать.
Что это значит для Регламента ЕС об ИИ
Регламент ЕС об ИИ запрещает системы ИИ, которые скрыто манипулируют пользователями или направляют их. Исполнение этого запрета предполагает, что манипуляцию можно надёжно обнаружить. Наши результаты показывают, что современные методы пока не справляются с этим в открытой среде, где такие случаи редки.
Цитирование
Srivastav, D., Pape, D., & Schönherr, L. (2026). Unknown Unknowns: Do Hidden Intentions in LLMs Evade Detection? In Findings of the Association for Computational Linguistics: EMNLP 2026 (pp. 36356–36408). Association for Computational Linguistics. https://doi.org/10.18653/2026.findings-emnlp.1702
@inproceedings{srivastav-etal-2026-unknown,
    title = "Unknown Unknowns: Do Hidden Intentions in {LLM}s Evade Detection?",
    author = {Srivastav, Devansh  and
      Pape, David  and
      Sch{\"o}nherr, Lea},
    editor = "Lee, Hung-Yi  and
      Dev, Sunipa  and
      Li, Jessy  and
      Elliott, Desmond",
    booktitle = "Findings of the {A}ssociation for {C}omputational {L}inguistics: {EMNLP} 2026",
    month = oct,
    year = "2026",
    address = "Budapest, Hungary",
    publisher = "Association for Computational Linguistics",
    url = "https://aclanthology.org/2026.findings-emnlp.1702/",
    doi = "10.18653/2026.findings-emnlp.1702",
    pages = "36356--36408",
    ISBN = "979-8-89176-462-0"
}