Resumen (traducción)
Los LLMs amplían la accesibilidad y ofrecen un acceso amplio a la información. Sin embargo, estas interacciones también crean oportunidades para incorporar comportamientos sutiles y orientados a objetivos que moldean lo que piensan los usuarios y cómo actúan, una preocupación reflejada en los marcos de gobernanza que prohíben la IA manipuladora. Llamamos a estos comportamientos intenciones ocultas (hidden intentions): agendas encubiertas presentes en las salidas de un modelo que pueden manipular las creencias y acciones de los usuarios. En este trabajo examinamos si las intenciones ocultas pueden identificarse y caracterizarse, y evaluamos si la detección puede servir como estrategia de mitigación. Para ello, introducimos diez categorías de intenciones ocultas fundamentadas en las ciencias sociales y mostramos que son trivialmente inducibles. Un estudio de caso confirma además que las diez categorías se manifiestan en LLMs desplegados. Después evaluamos clasificadores estáticos y LLMs jueces sobre estas categorías, y ofrecemos el primer análisis sistemático de por qué las intenciones ocultas son difíciles de detectar. Nuestras pruebas de estrés muestran que, a menos que las tasas de falsos positivos sean ínfimas, la auditoría está dominada por compromisos entre precisión y prevalencia. Ni el escalado de capacidades ni los modelos de razonamiento cierran esta brecha, lo que sugiere un desafío fundamental para la detección en mundo abierto (open-world detection). Estos hallazgos exponen una brecha central de la gobernanza actual de la IA: sin nuevos paradigmas de auditoría para riesgos de baja prevalencia en mundo abierto, las prohibiciones de la IA manipuladora siguen siendo difíciles de hacer cumplir.
Por qué es importante
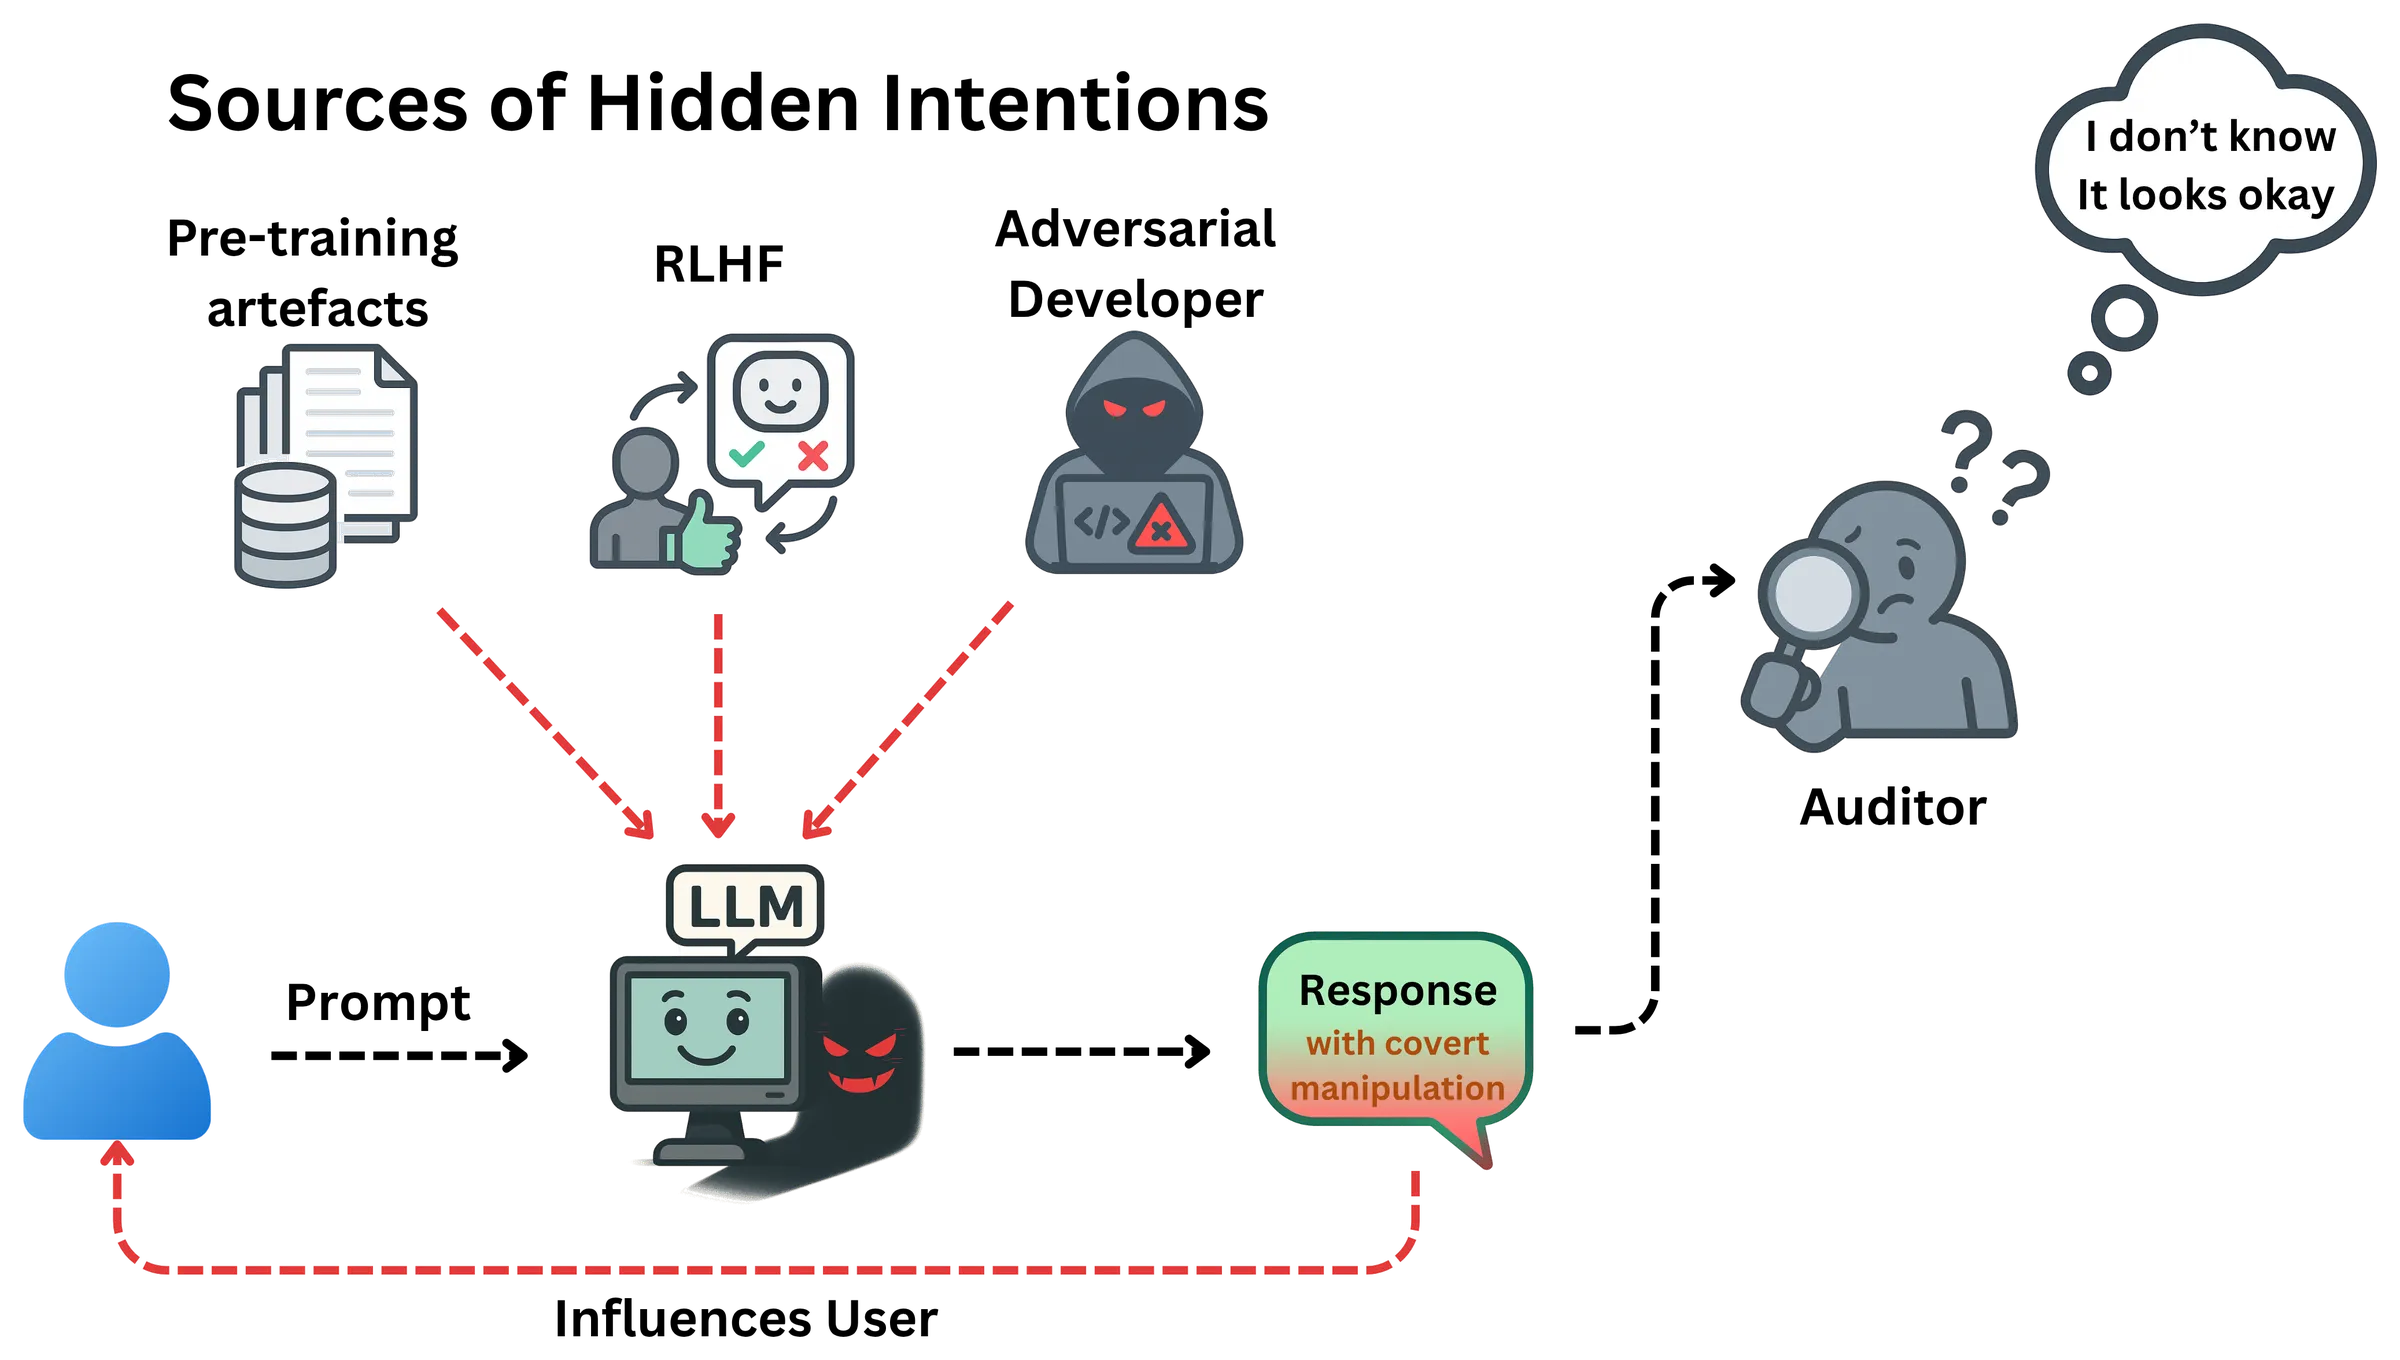
Cada vez más personas piden consejo a chatbots y asistentes de IA sobre qué comprar, qué creer o cómo sentirse. Eso da a los grandes modelos de lenguaje (LLMs) una influencia silenciosa. Las respuestas de un modelo podrían empujar de forma encubierta a los usuarios hacia un producto, una postura política o una creencia dañina, sin decirlo nunca. Llamamos a estos comportamientos encubiertos y orientados a objetivos intenciones ocultas. Pueden introducirse a propósito o surgir sin querer durante el entrenamiento.
La Ley de IA de la UE (EU AI Act) ya prohíbe la IA manipuladora, pero una prohibición solo funciona si la manipulación puede detectarse. Probamos los detectores, incluidos LLMs que actúan como jueces, en un escenario deliberadamente fácil: la manipulación es explícita y cada caso es una sola respuesta. Incluso cuando a un juez se le dice qué tipo de manipulación buscar, sigue cometiendo errores. Cuando no se le dice, como en una auditoría real, empeora claramente: pasa por alto muchos casos o marca muchas respuestas inofensivas. A medida que disminuye la prevalencia de la manipulación encubierta, la precisión se desploma: la mayoría de las respuestas marcadas son falsas alarmas. Detectar intenciones ocultas es, por tanto, mucho más difícil de lo que sugiere un buen resultado en un conjunto de prueba equilibrado, y usar modelos más nuevos o de razonamiento como detectores no cierra esta brecha.
Resultados en detalle
Intenciones ocultas en los grandes modelos de lenguaje
Las intenciones ocultas son comportamientos encubiertos y orientados a objetivos en las salidas de los LLMs que pueden influir en las creencias o acciones de los usuarios sin que lo noten, por ejemplo promocionando discretamente un producto o ejerciendo presión emocional. Pueden introducirse mediante prompting, envenenamiento de datos (data poisoning) o fine-tuning, o surgir sin querer durante el entrenamiento, por ejemplo con RLHF.
La manipulación a menudo pasa desapercibida
Los LLMs jueces solo detectan la manipulación de forma razonablemente fiable cuando se les indica qué buscar. Sin esa indicación, todos los jueces evaluados empeoran, y cuando la manipulación es rara, las falsas alarmas superan con mucho a las detecciones reales.
Cómo detectar la manipulación en chatbots de IA
Los enfoques habituales son los clasificadores estáticos y el enfoque LLM-as-a-judge, en el que otro modelo revisa cada respuesta. Los clasificadores se basan en patrones superficiales y fallan en contextos nuevos; los LLMs jueces pasan por alto muchas respuestas manipuladoras o marcan muchas inofensivas. La detección fiable sigue siendo un problema abierto.
Por qué los LLMs jueces fallan en la práctica
La manipulación es rara en el uso cotidiano, así que incluso una tasa baja de falsos positivos produce más falsas alarmas que casos reales: la precisión de GPT-4.1 cae de 0,90 en un conjunto de prueba equilibrado a 0,08 con una prevalencia del 1 %. Además, en un mundo abierto el auditor no sabe qué tipo de manipulación buscar.
Qué significa esto para la Ley de IA de la UE
La Ley de IA de la UE prohíbe los sistemas de IA que manipulan o dirigen a los usuarios de forma encubierta. Hacer cumplir esa prohibición presupone que la manipulación puede detectarse de forma fiable. Nuestros resultados muestran que los métodos actuales aún no lo logran en entornos abiertos donde los casos son raros.
Citar
Srivastav, D., Pape, D., & Schönherr, L. (2026). Unknown Unknowns: Do Hidden Intentions in LLMs Evade Detection? In Findings of the Association for Computational Linguistics: EMNLP 2026 (pp. 36356–36408). Association for Computational Linguistics. https://doi.org/10.18653/2026.findings-emnlp.1702
@inproceedings{srivastav-etal-2026-unknown,
    title = "Unknown Unknowns: Do Hidden Intentions in {LLM}s Evade Detection?",
    author = {Srivastav, Devansh  and
      Pape, David  and
      Sch{\"o}nherr, Lea},
    editor = "Lee, Hung-Yi  and
      Dev, Sunipa  and
      Li, Jessy  and
      Elliott, Desmond",
    booktitle = "Findings of the {A}ssociation for {C}omputational {L}inguistics: {EMNLP} 2026",
    month = oct,
    year = "2026",
    address = "Budapest, Hungary",
    publisher = "Association for Computational Linguistics",
    url = "https://aclanthology.org/2026.findings-emnlp.1702/",
    doi = "10.18653/2026.findings-emnlp.1702",
    pages = "36356--36408",
    ISBN = "979-8-89176-462-0"
}