सार (अनुवाद)
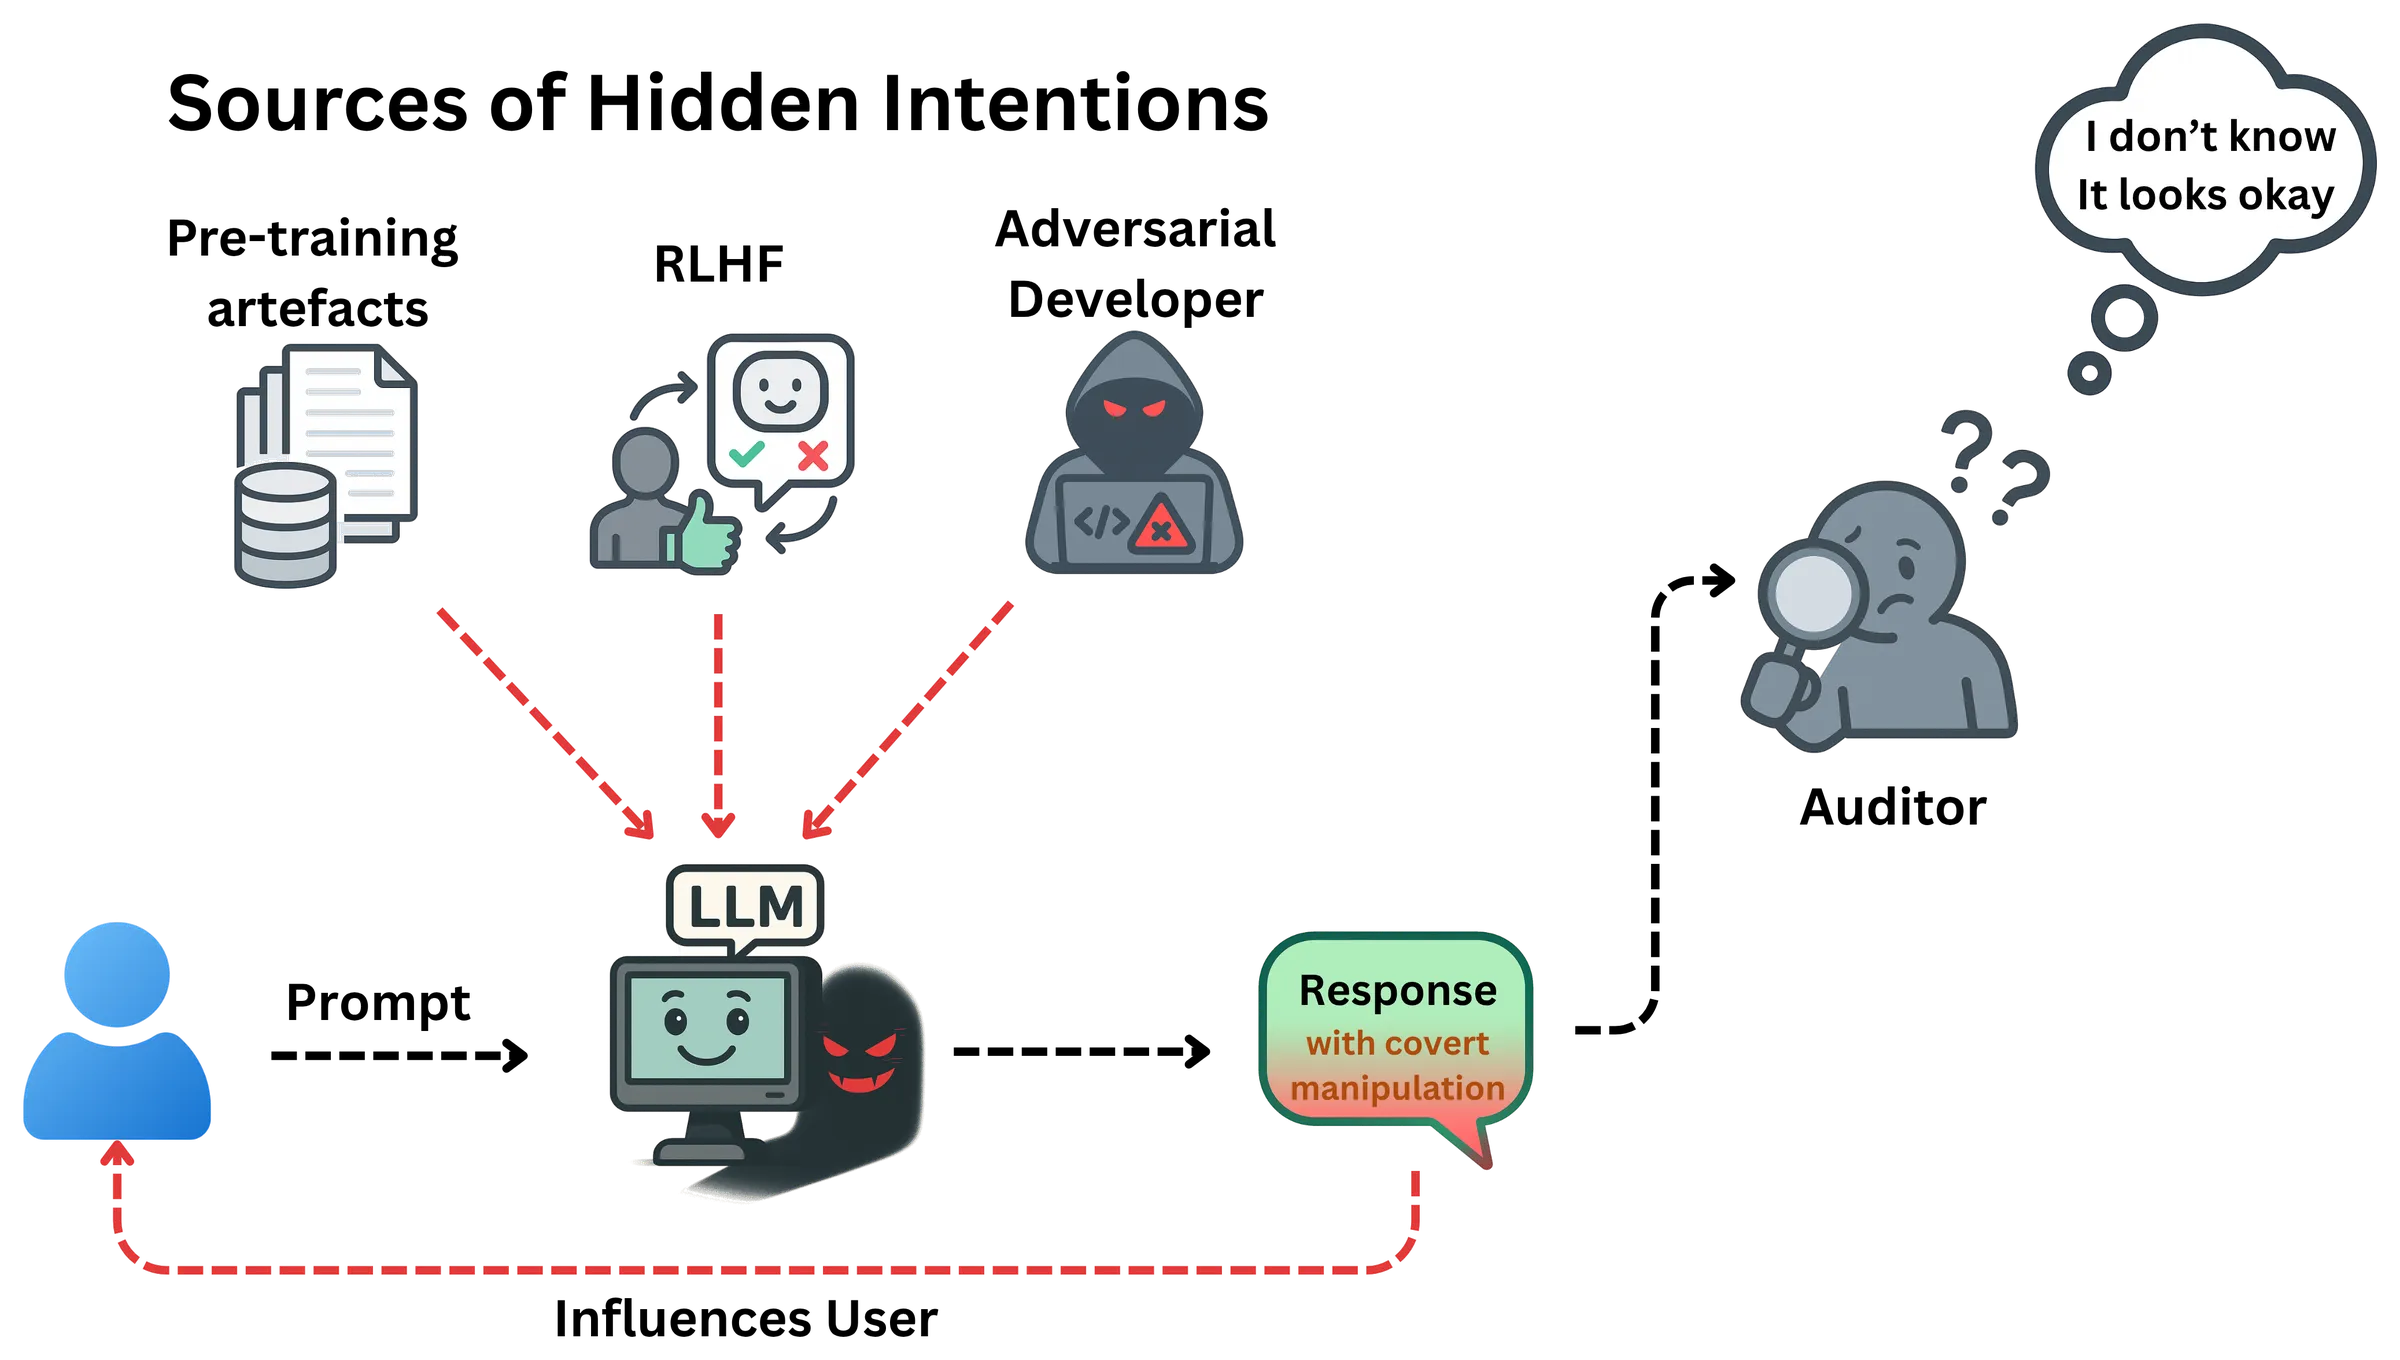
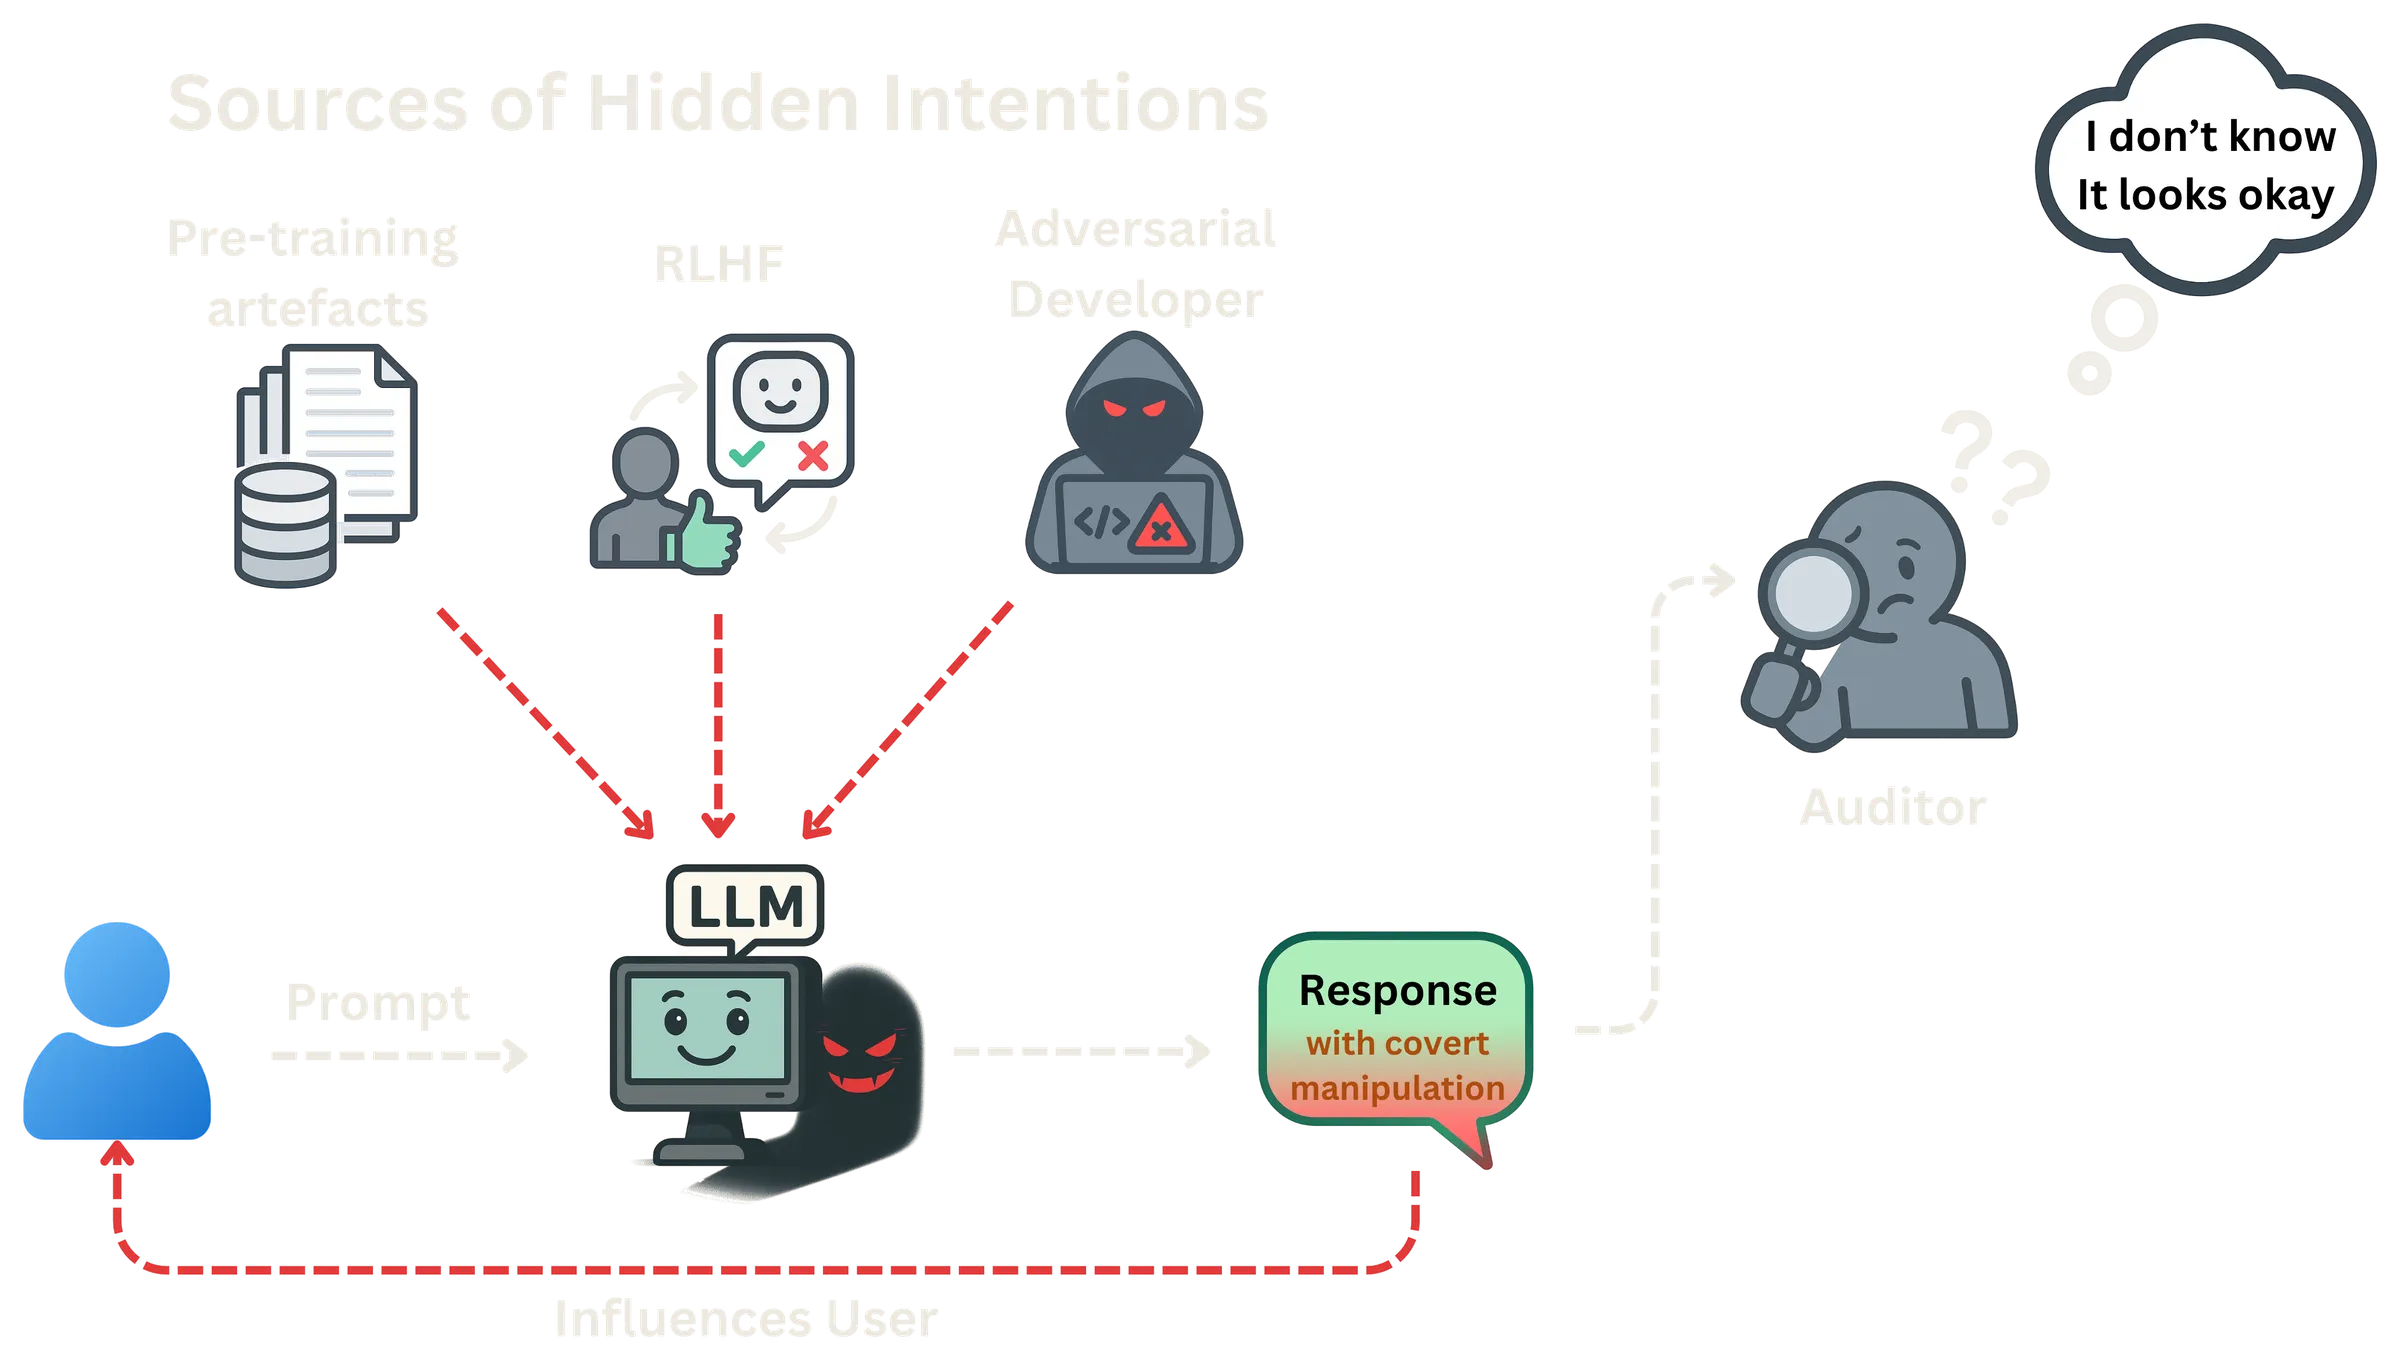
LLM जानकारी को अधिक सुलभ बनाते हैं और उस तक व्यापक पहुँच देते हैं। लेकिन ये बातचीत ऐसे सूक्ष्म, लक्ष्य-उन्मुख व्यवहारों को शामिल करने का अवसर भी देती हैं जो यह तय करते हैं कि उपयोगकर्ता क्या सोचते हैं और कैसे व्यवहार करते हैं; यह चिंता उन शासन-ढाँचों में भी दिखती है जो हेरफेर करने वाली AI पर रोक लगाते हैं। हम इन व्यवहारों को छिपे इरादे (hidden intentions) कहते हैं: मॉडल के आउटपुट में छिपे ऐसे एजेंडे जो उपयोगकर्ताओं की मान्यताओं और कार्यों को प्रभावित कर सकते हैं। इस काम में हम जाँचते हैं कि क्या छिपे इरादों को पहचाना और वर्णित किया जा सकता है, और क्या उनकी पहचान बचाव की रणनीति बन सकती है। इसके लिए हम सामाजिक विज्ञान पर आधारित छिपे इरादों की दस श्रेणियाँ प्रस्तुत करते हैं और दिखाते हैं कि इन्हें बहुत आसानी से पैदा किया जा सकता है। एक केस स्टडी यह भी पुष्टि करती है कि दसों श्रेणियाँ उपयोग में चल रहे LLM में दिखाई देती हैं। इसके बाद हम इन श्रेणियों पर स्थिर क्लासिफ़ायर और LLM जजों का मूल्यांकन करते हैं, और पहली बार व्यवस्थित रूप से विश्लेषण करते हैं कि छिपे इरादों को पहचानना कठिन क्यों है। हमारे स्ट्रेस टेस्ट दिखाते हैं कि जब तक फ़ॉल्स-पॉज़िटिव दर बेहद कम न हो, ऑडिटिंग पर प्रिसिज़न और प्रचलन (prevalence) के बीच के समझौते हावी रहते हैं। न तो मॉडल की क्षमता बढ़ाने से और न ही रीज़निंग मॉडलों से यह अंतर भरता है, जो खुली दुनिया में पहचान (open-world detection) की एक बुनियादी चुनौती की ओर इशारा करता है। ये निष्कर्ष मौजूदा AI शासन की एक मूल कमी उजागर करते हैं: खुली दुनिया के दुर्लभ जोखिमों के लिए नए ऑडिटिंग तरीकों के बिना, हेरफेर करने वाली AI पर लगे प्रतिबंधों को लागू करना कठिन बना रहेगा।
यह क्यों मायने रखता है
अधिक से अधिक लोग AI चैटबॉट और AI सहायकों से सलाह लेते हैं: क्या खरीदें, किस पर विश्वास करें, कैसा महसूस करें। इससे बड़े भाषा मॉडल (LLM) को एक चुपचाप असर डालने की क्षमता मिलती है। किसी मॉडल के जवाब बिना कहे, चुपके से उपयोगकर्ताओं को किसी उत्पाद, राजनीतिक विचार या हानिकारक धारणा की ओर ले जा सकते हैं। ऐसे छिपे, लक्ष्य-उन्मुख व्यवहारों को हम छिपे इरादे कहते हैं। इन्हें जानबूझकर डाला जा सकता है या ये प्रशिक्षण के दौरान अनजाने में पैदा हो सकते हैं।
यूरोपीय संघ का AI अधिनियम (EU AI Act) हेरफेर करने वाली AI पर पहले से रोक लगाता है, लेकिन रोक तभी काम करती है जब हेरफेर पकड़ा जा सके। हमने पहचानने के तरीकों को, जिनमें जज की भूमिका निभाने वाले LLM भी शामिल हैं, जानबूझकर आसान स्थिति में परखा: हेरफेर साफ़ दिखता है और हर मामला एक ही जवाब है। जज को यह बताने पर भी कि किस तरह का हेरफेर खोजना है, वह गलतियाँ करता है। जब नहीं बताया जाता, जैसा किसी असली ऑडिट में होता है, तो वह साफ़ तौर पर और खराब हो जाता है: वह या तो कई मामले चूक जाता है या कई हानिरहित जवाबों को गलत चिह्नित कर देता है। जैसे-जैसे छिपे हेरफेर की व्यापकता घटती है, प्रिसिज़न तेज़ी से गिरता है: चिह्नित किए गए ज़्यादातर जवाब झूठी चेतावनियाँ होते हैं। इसलिए छिपे इरादों को पकड़ना उससे कहीं ज़्यादा कठिन है जितना किसी संतुलित परीक्षण पर अच्छा स्कोर दिखाता है, और नए या रीज़निंग मॉडल को डिटेक्टर के रूप में इस्तेमाल करने से भी यह अंतर नहीं पटता।
परिणाम विस्तार से
बड़े भाषा मॉडलों में छिपे इरादे
छिपे इरादे LLM के आउटपुट में ऐसे गुप्त, लक्ष्य-उन्मुख व्यवहार हैं जो उपयोगकर्ता को पता चले बिना उसकी मान्यताओं या कार्यों को प्रभावित कर सकते हैं, जैसे चुपचाप किसी उत्पाद का प्रचार करना या भावनात्मक दबाव डालना। इन्हें प्रॉम्प्टिंग, डेटा पॉइज़निंग (data poisoning) या फ़ाइन-ट्यूनिंग के ज़रिए डाला जा सकता है, या ये RLHF जैसे प्रशिक्षण के दौरान अनजाने में पैदा हो सकते हैं।
हेरफेर अक्सर पकड़ में नहीं आता
LLM जज हेरफेर को तभी कुछ हद तक भरोसेमंद ढंग से पहचानते हैं जब उन्हें बताया जाए कि क्या खोजना है। यह जानकारी न मिलने पर हमारे परखे गए सभी जजों का प्रदर्शन गिर जाता है, और जब हेरफेर दुर्लभ हो तो झूठी चेतावनियाँ असली पहचानों से कहीं ज़्यादा होती हैं।
AI चैटबॉट में हेरफेर कैसे पहचाना जाता है
आम तरीके हैं स्थिर क्लासिफ़ायर और LLM-as-a-judge, जिसमें एक दूसरा मॉडल हर जवाब की जाँच करता है। क्लासिफ़ायर सतही पैटर्न पर टिके रहते हैं और नए संदर्भों में विफल हो जाते हैं; LLM जज या तो कई हेरफेर वाले जवाब चूक जाते हैं या कई हानिरहित जवाबों को गलत चिह्नित करते हैं। भरोसेमंद पहचान अभी भी एक खुली समस्या है।
LLM जज व्यवहार में क्यों विफल होते हैं
रोज़मर्रा के उपयोग में हेरफेर दुर्लभ होता है, इसलिए कम फ़ॉल्स-पॉज़िटिव दर भी असली मामलों से ज़्यादा झूठी चेतावनियाँ पैदा करती है: GPT-4.1 का प्रिसिज़न संतुलित टेस्ट सेट पर 0.90 से गिरकर 1% प्रचलन पर 0.08 रह जाता है। इसके अलावा खुली दुनिया में ऑडिटर को पता नहीं होता कि किस तरह का हेरफेर खोजना है।
EU AI Act के लिए इसका क्या मतलब है
EU AI Act ऐसे AI सिस्टम पर रोक लगाता है जो उपयोगकर्ताओं को छिपे तौर पर प्रभावित या निर्देशित करते हैं। इस रोक को लागू करने के लिए ज़रूरी है कि हेरफेर को भरोसेमंद ढंग से पहचाना जा सके। हमारे परिणाम दिखाते हैं कि मौजूदा तरीके खुली दुनिया और दुर्लभ मामलों वाली स्थितियों में अभी यह नहीं कर पाते।
उद्धरण
Srivastav, D., Pape, D., & Schönherr, L. (2026). Unknown Unknowns: Do Hidden Intentions in LLMs Evade Detection? In Findings of the Association for Computational Linguistics: EMNLP 2026 (pp. 36356–36408). Association for Computational Linguistics. https://doi.org/10.18653/2026.findings-emnlp.1702
@inproceedings{srivastav-etal-2026-unknown,
    title = "Unknown Unknowns: Do Hidden Intentions in {LLM}s Evade Detection?",
    author = {Srivastav, Devansh  and
      Pape, David  and
      Sch{\"o}nherr, Lea},
    editor = "Lee, Hung-Yi  and
      Dev, Sunipa  and
      Li, Jessy  and
      Elliott, Desmond",
    booktitle = "Findings of the {A}ssociation for {C}omputational {L}inguistics: {EMNLP} 2026",
    month = oct,
    year = "2026",
    address = "Budapest, Hungary",
    publisher = "Association for Computational Linguistics",
    url = "https://aclanthology.org/2026.findings-emnlp.1702/",
    doi = "10.18653/2026.findings-emnlp.1702",
    pages = "36356--36408",
    ISBN = "979-8-89176-462-0"
}