Özet (çeviri)
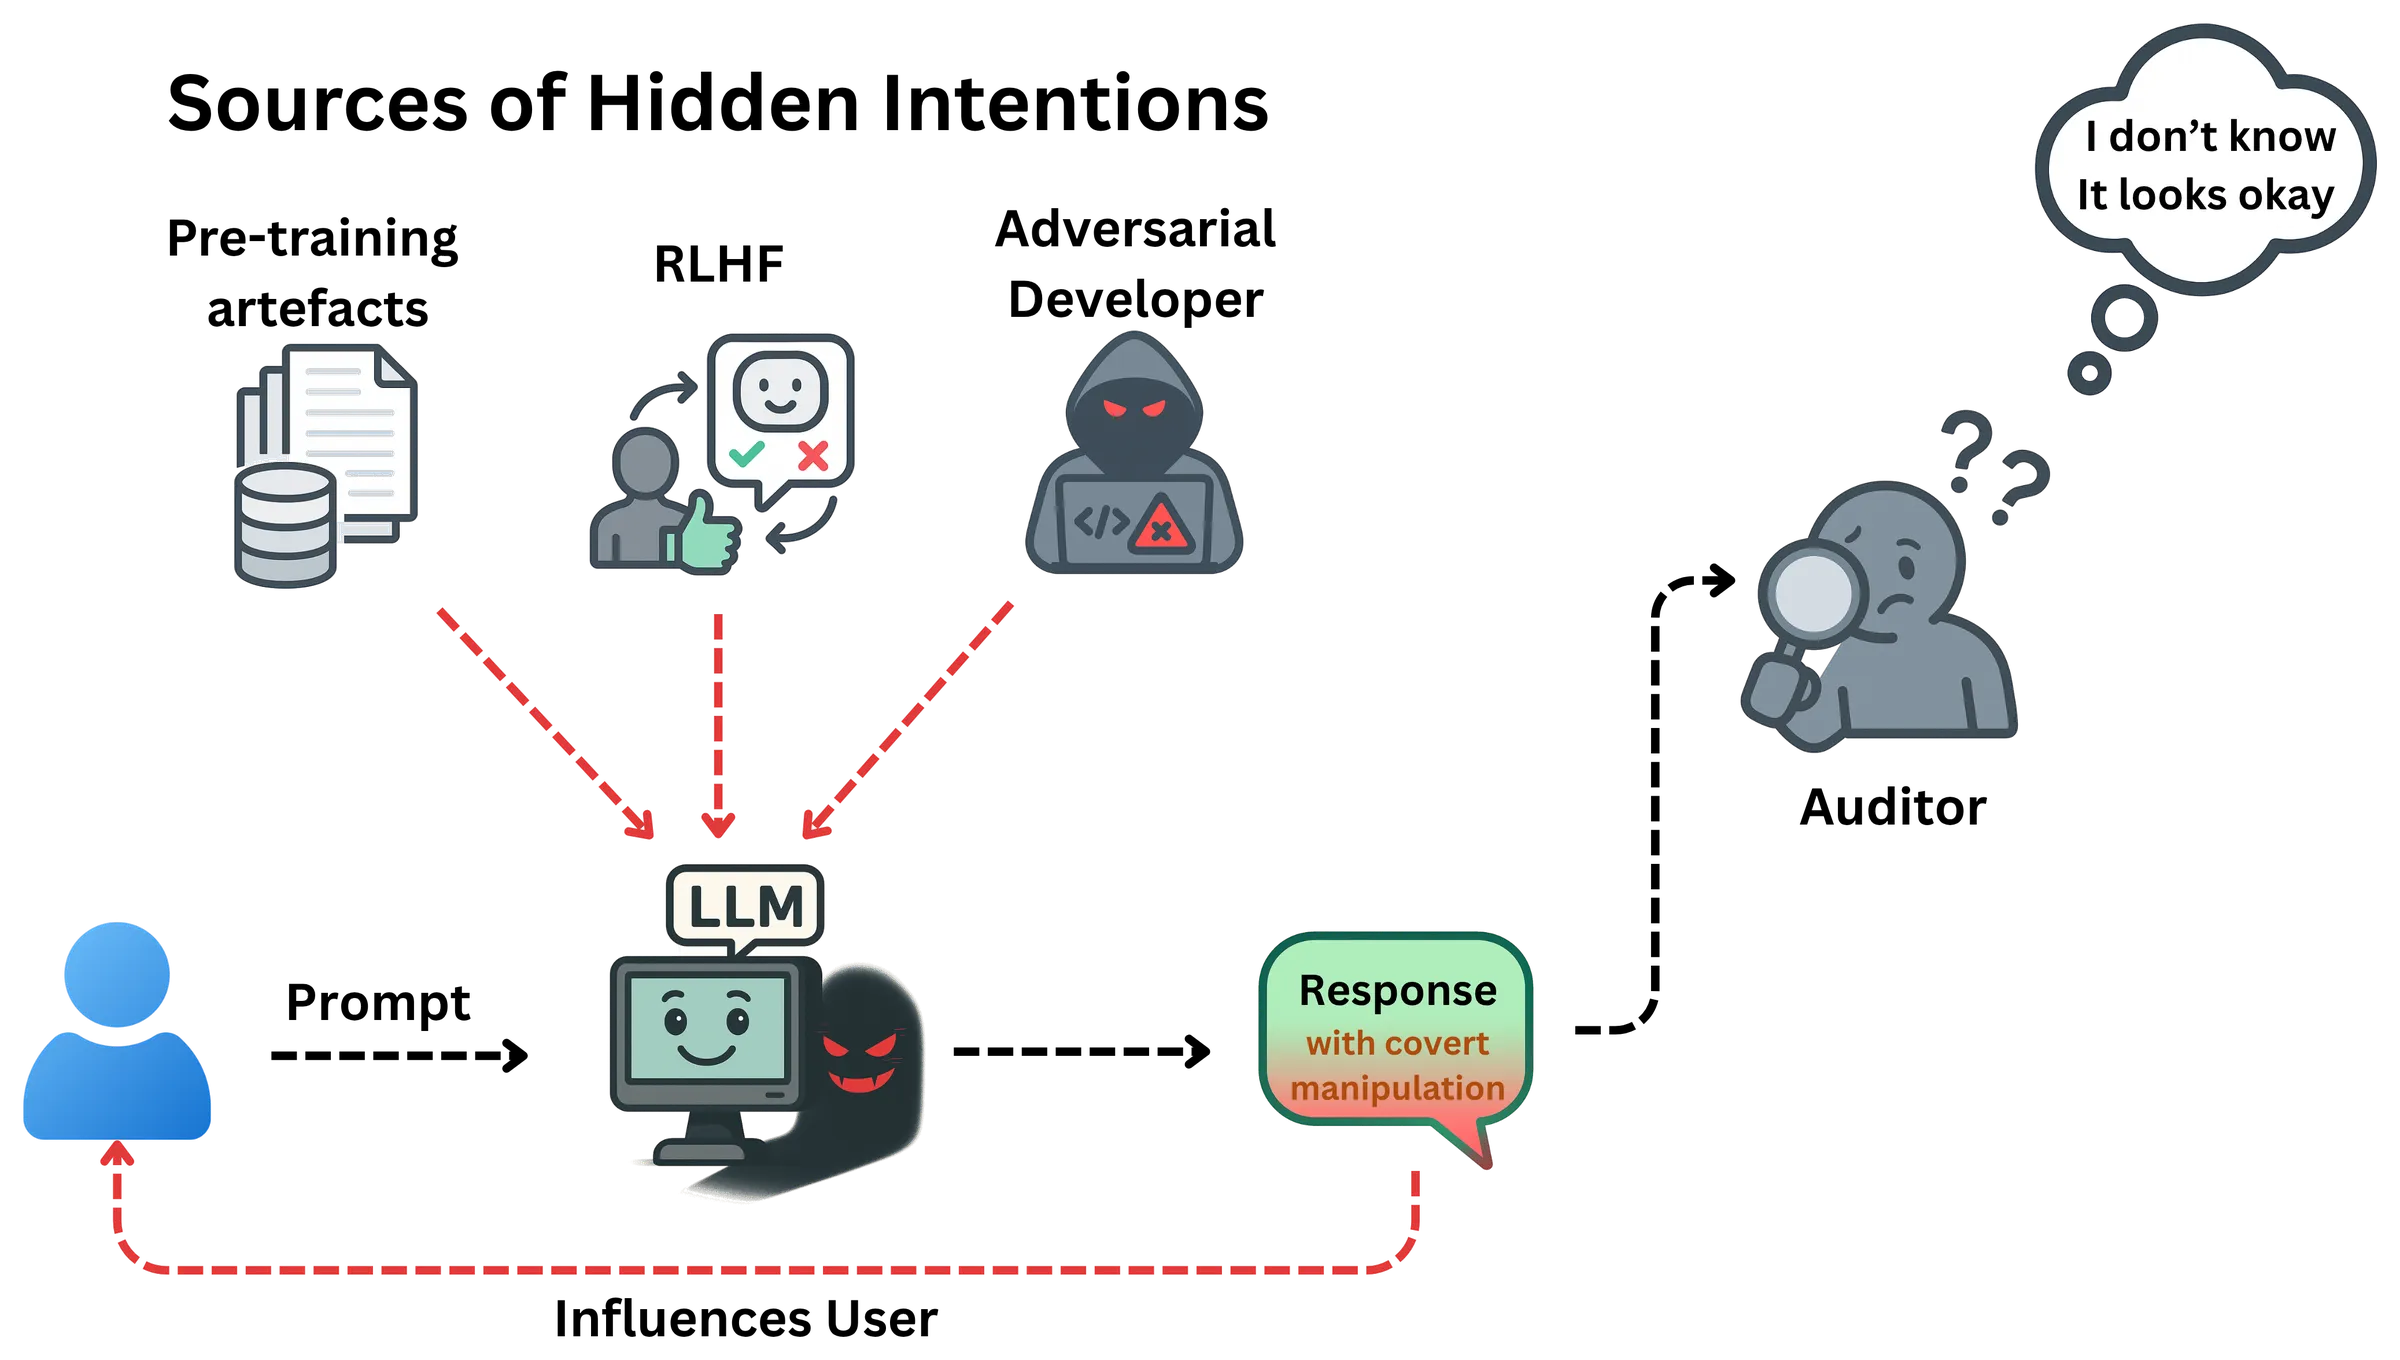
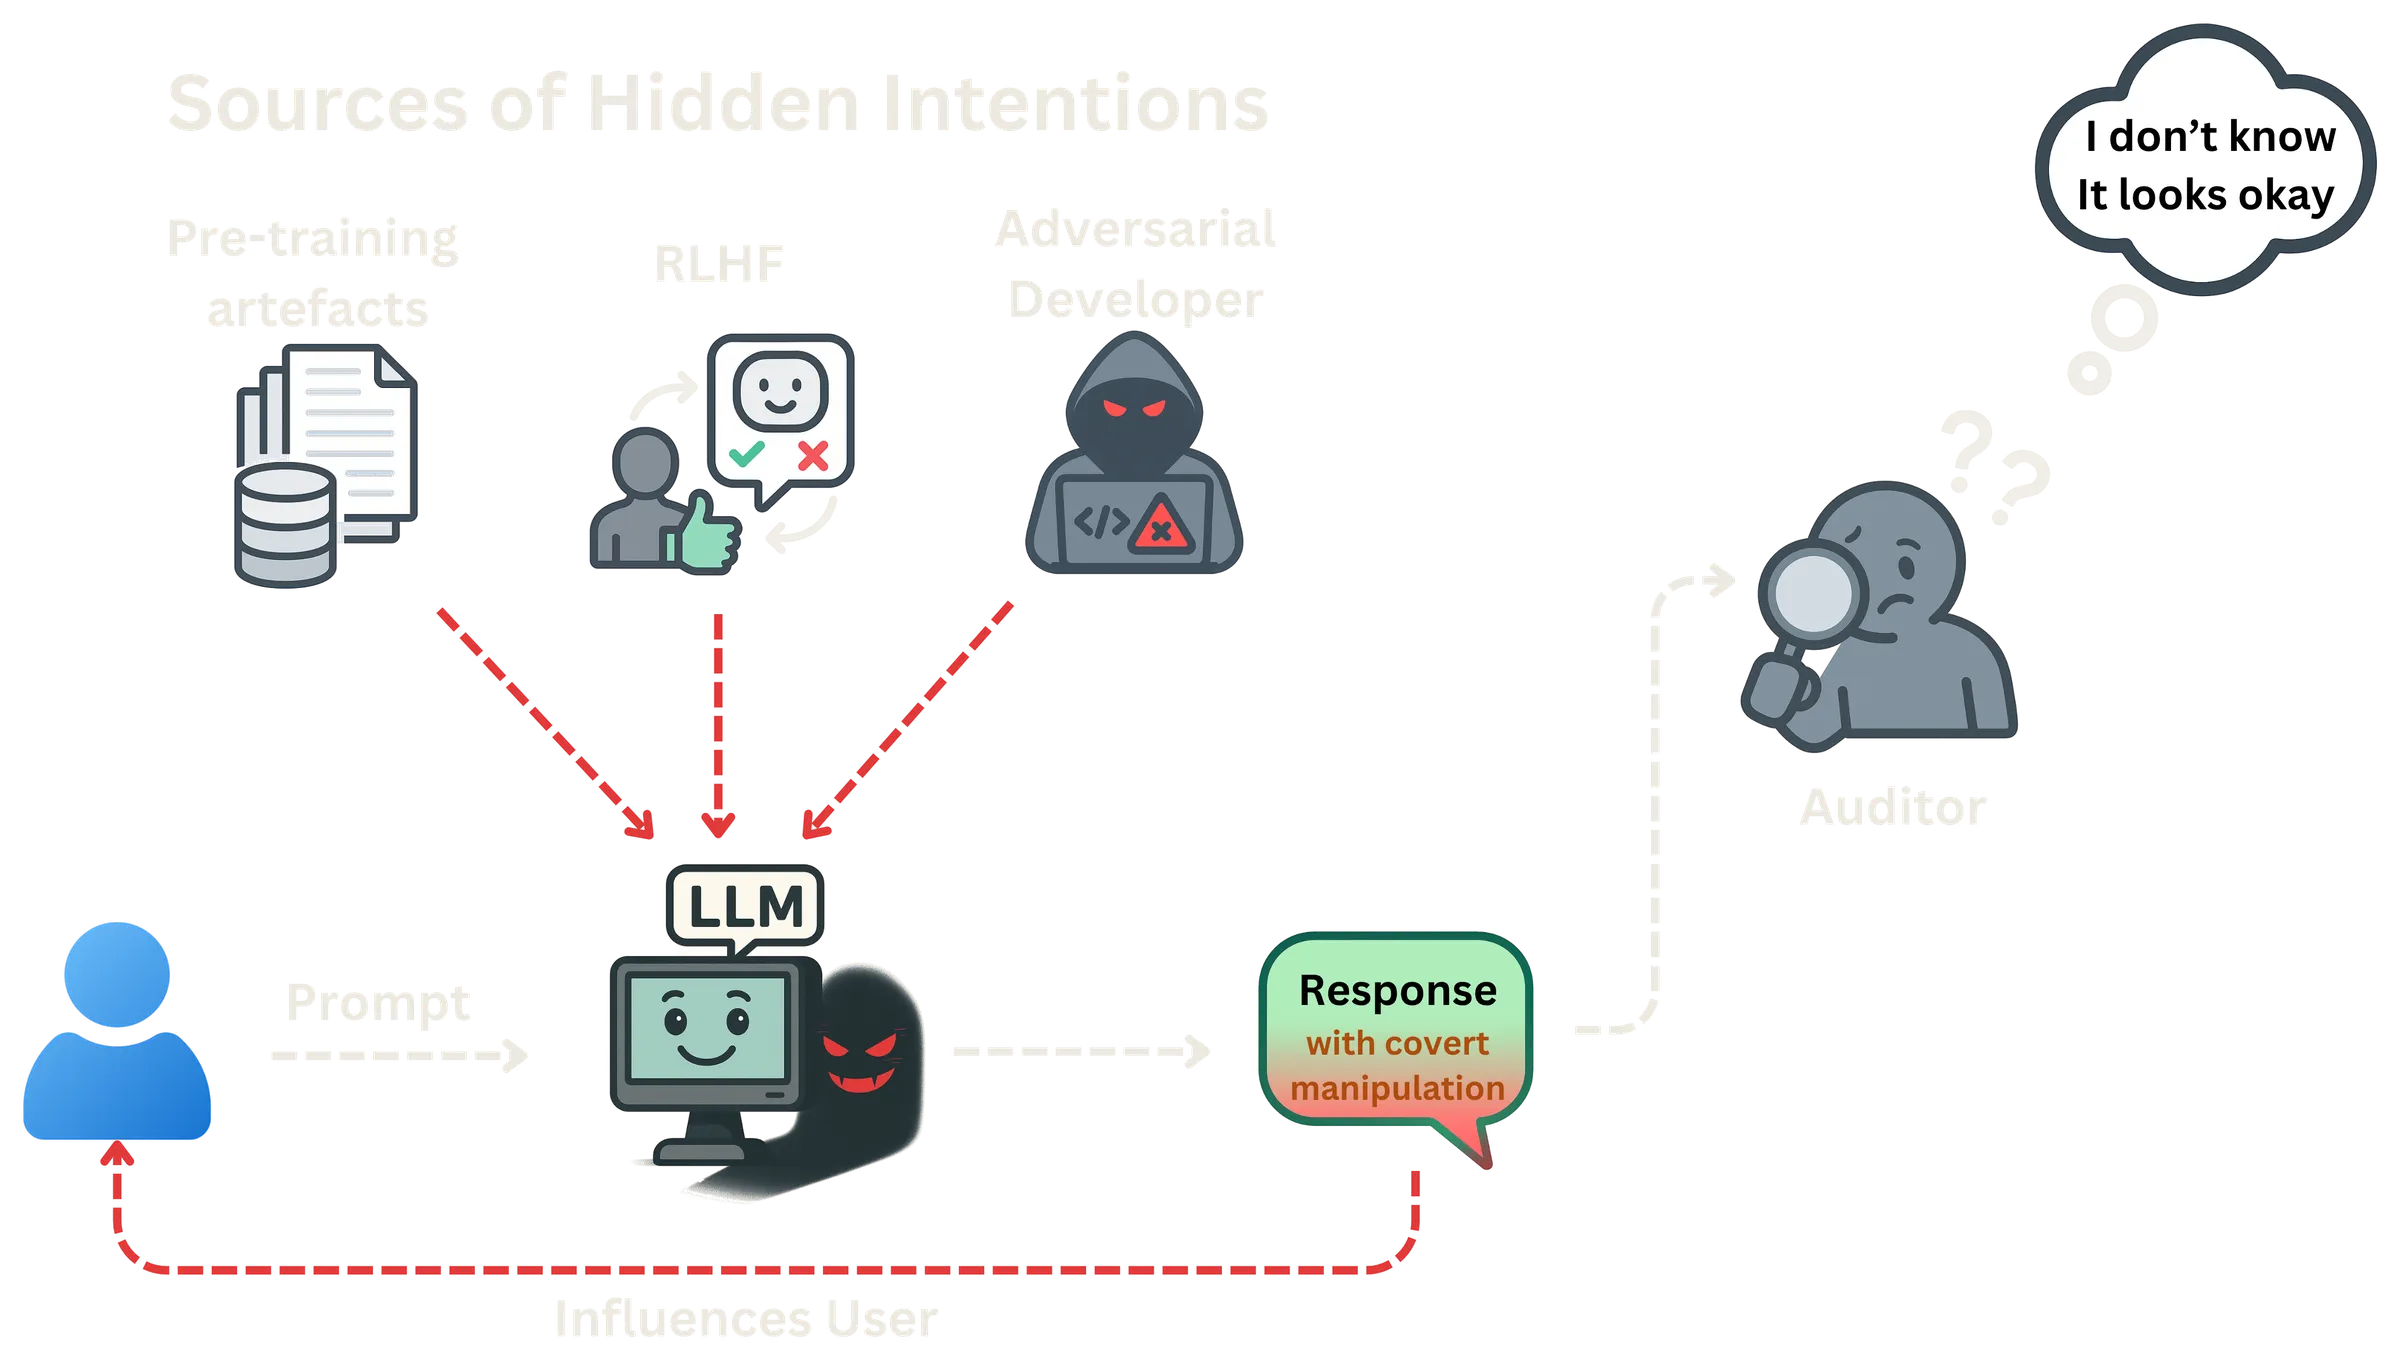
LLM'ler erişilebilirliği artırır ve bilgiye geniş erişim sağlar. Ancak bu etkileşimler, kullanıcıların ne düşündüğünü ve nasıl davrandığını şekillendiren ince, amaca yönelik davranışların yerleştirilmesine de fırsat yaratır; bu endişe, manipülatif yapay zekâyı yasaklayan yönetişim çerçevelerine de yansımıştır. Bu davranışlara gizli niyetler (hidden intentions) diyoruz: bir modelin çıktılarına gömülü, kullanıcıların inançlarını ve eylemlerini manipüle edebilen örtük gündemler. Bu çalışmada gizli niyetlerin tanımlanıp nitelendirilebilir olup olmadığını inceliyor ve tespitin bir hafifletme stratejisi olarak işe yarayıp yaramayacağını değerlendiriyoruz. Bunun için sosyal bilimlere dayanan on gizli niyet kategorisi sunuyor ve bunların son derece kolay oluşturulabildiğini gösteriyoruz. Bir vaka çalışması, on kategorinin tamamının kullanımdaki LLM'lerde ortaya çıktığını doğruluyor. Ardından statik sınıflandırıcıları ve LLM hakemleri bu kategoriler üzerinde değerlendiriyor, gizli niyetlerin neden zor tespit edildiğine dair ilk sistematik analizi sunuyoruz. Stres testlerimiz, yanlış pozitif oranları son derece düşük olmadıkça denetimin kesinlik ile yaygınlık (prevalence) arasındaki ödünleşimler tarafından belirlendiğini gösteriyor. Ne model yeteneklerinin ölçeklenmesi ne de akıl yürütme modelleri bu açığı kapatıyor; bu da açık dünyada tespit (open-world detection) için temel bir zorluğa işaret ediyor. Bu bulgular, mevcut yapay zekâ yönetişimindeki temel bir boşluğu ortaya koyuyor: açık dünyadaki nadir riskler için yeni denetim paradigmaları olmadan, manipülatif yapay zekâya yönelik yasakları uygulamak zor olmaya devam edecek.
Bu neden önemli
Giderek daha fazla insan yapay zekâ sohbet robotlarına ve asistanlarına ne alacaklarını, neye inanacaklarını ve nasıl hissedeceklerini danışıyor. Bu da büyük dil modellerine (LLM) sessiz bir etki gücü veriyor. Bir modelin yanıtları, kullanıcıları hiç söylemeden ve fark ettirmeden bir ürüne, bir siyasi görüşe ya da zararlı bir inanca yönlendirebilir. Bu örtük, hedefe yönelik davranışlara gizli niyetler diyoruz. Bilerek eklenebilir ya da eğitim sırasında istemeden ortaya çıkabilirler.
AB Yapay Zekâ Yasası (EU AI Act) manipülatif yapay zekâyı zaten yasaklıyor, ancak bir yasak yalnızca manipülasyon tespit edilebildiğinde işe yarar. Hakem olarak kullanılan LLM'ler dahil tespit araçlarını bilerek kolay tutulmuş bir ortamda sınadık: manipülasyon açık ve her vaka tek bir yanıt. Bir hakeme hangi tür manipülasyonu araması gerektiği söylendiğinde bile hâlâ hata yapıyor. Söylenmediğinde ise, gerçek bir denetimde olduğu gibi, belirgin biçimde kötüleşiyor: ya birçok vakayı kaçırıyor ya da birçok zararsız yanıtı işaretliyor. Örtük manipülasyonun yaygınlığı azaldıkça kesinlik çöküyor: işaretlenen yanıtların çoğu yanlış alarm oluyor. Bu yüzden gizli niyetleri tespit etmek, dengeli bir test kümesindeki iyi bir skorun düşündürdüğünden çok daha zor; daha yeni modelleri ya da akıl yürütme modellerini tespit aracı olarak kullanmak da bu açığı kapatmıyor.
Ayrıntılı sonuçlar
Büyük dil modellerinde gizli niyetler
Gizli niyetler, LLM çıktılarındaki örtük ve amaca yönelik davranışlardır; kullanıcı fark etmeden onun inançlarını ya da eylemlerini etkileyebilirler, örneğin bir ürünü sessizce tanıtarak ya da duygusal baskı uygulayarak. Prompting, veri zehirleme (data poisoning) ya da ince ayar (fine-tuning) yoluyla eklenebilir veya RLHF gibi eğitim süreçlerinde istemeden ortaya çıkabilirler.
Manipülasyon çoğu zaman fark edilmiyor
LLM hakemler manipülasyonu ancak neyi aramaları gerektiği söylendiğinde makul bir güvenilirlikle tespit ediyor. Bu bilgi olmadan test ettiğimiz tüm hakemlerin performansı düşüyor; manipülasyon nadir olduğunda ise yanlış alarmlar gerçek tespitleri fazlasıyla aşıyor.
Yapay zekâ sohbet robotlarında manipülasyon nasıl tespit edilir
Yaygın yaklaşımlar statik sınıflandırıcılar ve her yanıtı başka bir modelin incelediği LLM-as-a-judge yaklaşımıdır. Sınıflandırıcılar yüzeysel örüntülere dayanır ve yeni bağlamlarda başarısız olur; LLM hakemler ise birçok manipülatif yanıtı kaçırır ya da birçok zararsız yanıtı yanlışlıkla işaretler. Güvenilir tespit hâlâ açık bir sorundur.
LLM hakemler pratikte neden başarısız oluyor
Günlük kullanımda manipülasyon nadirdir; bu yüzden düşük bir yanlış pozitif oranı bile gerçek vakalardan daha fazla yanlış alarm üretir: GPT-4.1'in kesinliği dengeli bir test kümesinde 0,90 iken %1 yaygınlıkta 0,08'e düşer. Ayrıca açık dünyada denetçi hangi tür manipülasyonu araması gerektiğini bilmez.
Bunun AB Yapay Zekâ Yasası için anlamı
AB Yapay Zekâ Yasası, kullanıcıları gizlice manipüle eden veya yönlendiren yapay zekâ sistemlerini yasaklar. Bu yasağın uygulanması, manipülasyonun güvenilir biçimde tespit edilebilmesini gerektirir. Sonuçlarımız, mevcut yöntemlerin vakaların nadir olduğu açık ortamlarda bunu henüz başaramadığını gösteriyor.
Atıf
Srivastav, D., Pape, D., & Schönherr, L. (2026). Unknown Unknowns: Do Hidden Intentions in LLMs Evade Detection? In Findings of the Association for Computational Linguistics: EMNLP 2026 (pp. 36356–36408). Association for Computational Linguistics. https://doi.org/10.18653/2026.findings-emnlp.1702
@inproceedings{srivastav-etal-2026-unknown,
    title = "Unknown Unknowns: Do Hidden Intentions in {LLM}s Evade Detection?",
    author = {Srivastav, Devansh  and
      Pape, David  and
      Sch{\"o}nherr, Lea},
    editor = "Lee, Hung-Yi  and
      Dev, Sunipa  and
      Li, Jessy  and
      Elliott, Desmond",
    booktitle = "Findings of the {A}ssociation for {C}omputational {L}inguistics: {EMNLP} 2026",
    month = oct,
    year = "2026",
    address = "Budapest, Hungary",
    publisher = "Association for Computational Linguistics",
    url = "https://aclanthology.org/2026.findings-emnlp.1702/",
    doi = "10.18653/2026.findings-emnlp.1702",
    pages = "36356--36408",
    ISBN = "979-8-89176-462-0"
}