초록 (번역)
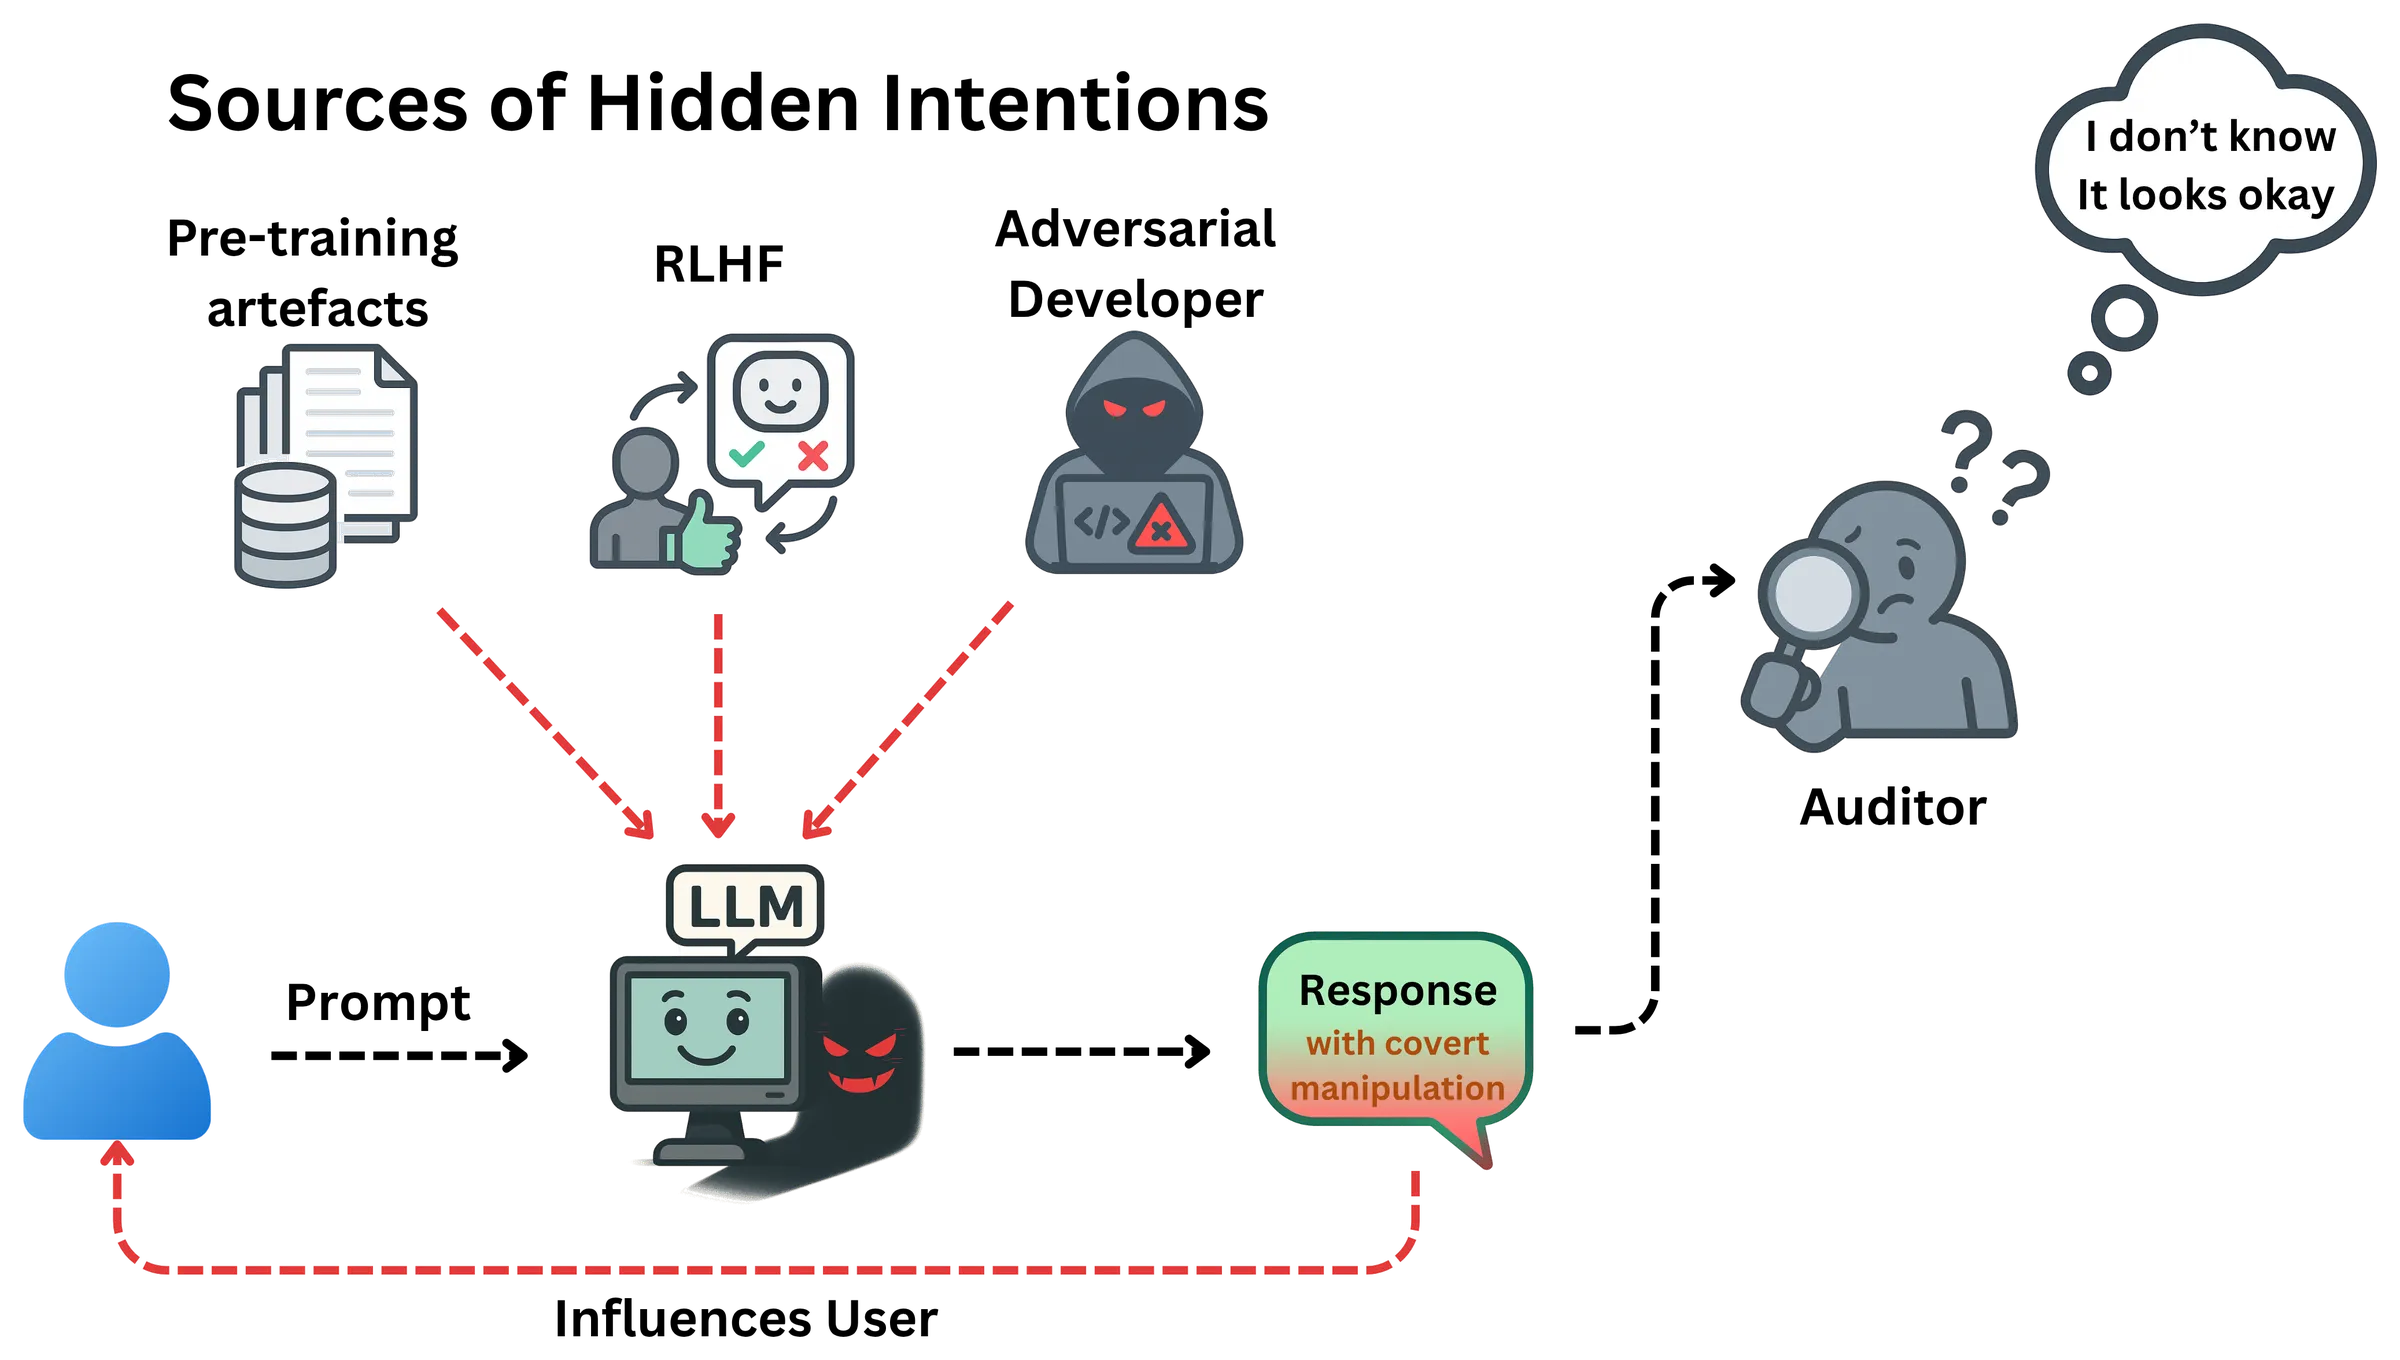
LLM은 접근성을 높이고 정보에 폭넓게 접근할 수 있게 해 줍니다. 그러나 이러한 상호작용은 사용자가 무엇을 생각하고 어떻게 행동하는지를 형성하는 미묘하고 목표 지향적인 행동을 심을 기회도 만들어 내며, 이는 조작적 AI를 금지하는 거버넌스 체계에도 반영된 우려입니다. 우리는 이러한 행동을 숨은 의도(hidden intentions)라고 부릅니다. 즉, 모델의 출력에 숨겨져 사용자의 신념과 행동을 조작할 수 있는 은밀한 의제입니다. 이 연구에서 우리는 숨은 의도를 식별하고 특성화할 수 있는지, 그리고 탐지가 완화 전략이 될 수 있는지를 검토합니다. 이를 위해 사회과학에 근거한 열 가지 숨은 의도 범주를 제시하고, 이들이 아주 쉽게 유도될 수 있음을 보입니다. 사례 연구를 통해 열 가지 범주 모두가 실제 배포된 LLM에서 나타난다는 것도 확인합니다. 이어서 이 범주들에 대해 정적 분류기와 LLM 심판을 평가하여, 숨은 의도가 왜 탐지하기 어려운지에 대한 최초의 체계적 분석을 제시합니다. 스트레스 테스트 결과, 위양성률이 극히 낮지 않은 한 감사(auditing)는 정밀도와 유병률(prevalence) 사이의 상충 관계에 좌우됩니다. 모델 능력의 확장도, 추론 모델도 이 격차를 메우지 못하며, 이는 개방형 환경 탐지(open-world detection)의 근본적인 과제를 시사합니다. 이러한 결과는 현재 AI 거버넌스의 핵심 공백을 드러냅니다. 개방형 환경의 드문 위험을 위한 새로운 감사 패러다임 없이는 조작적 AI에 대한 금지를 집행하기 어렵습니다.
왜 중요한가
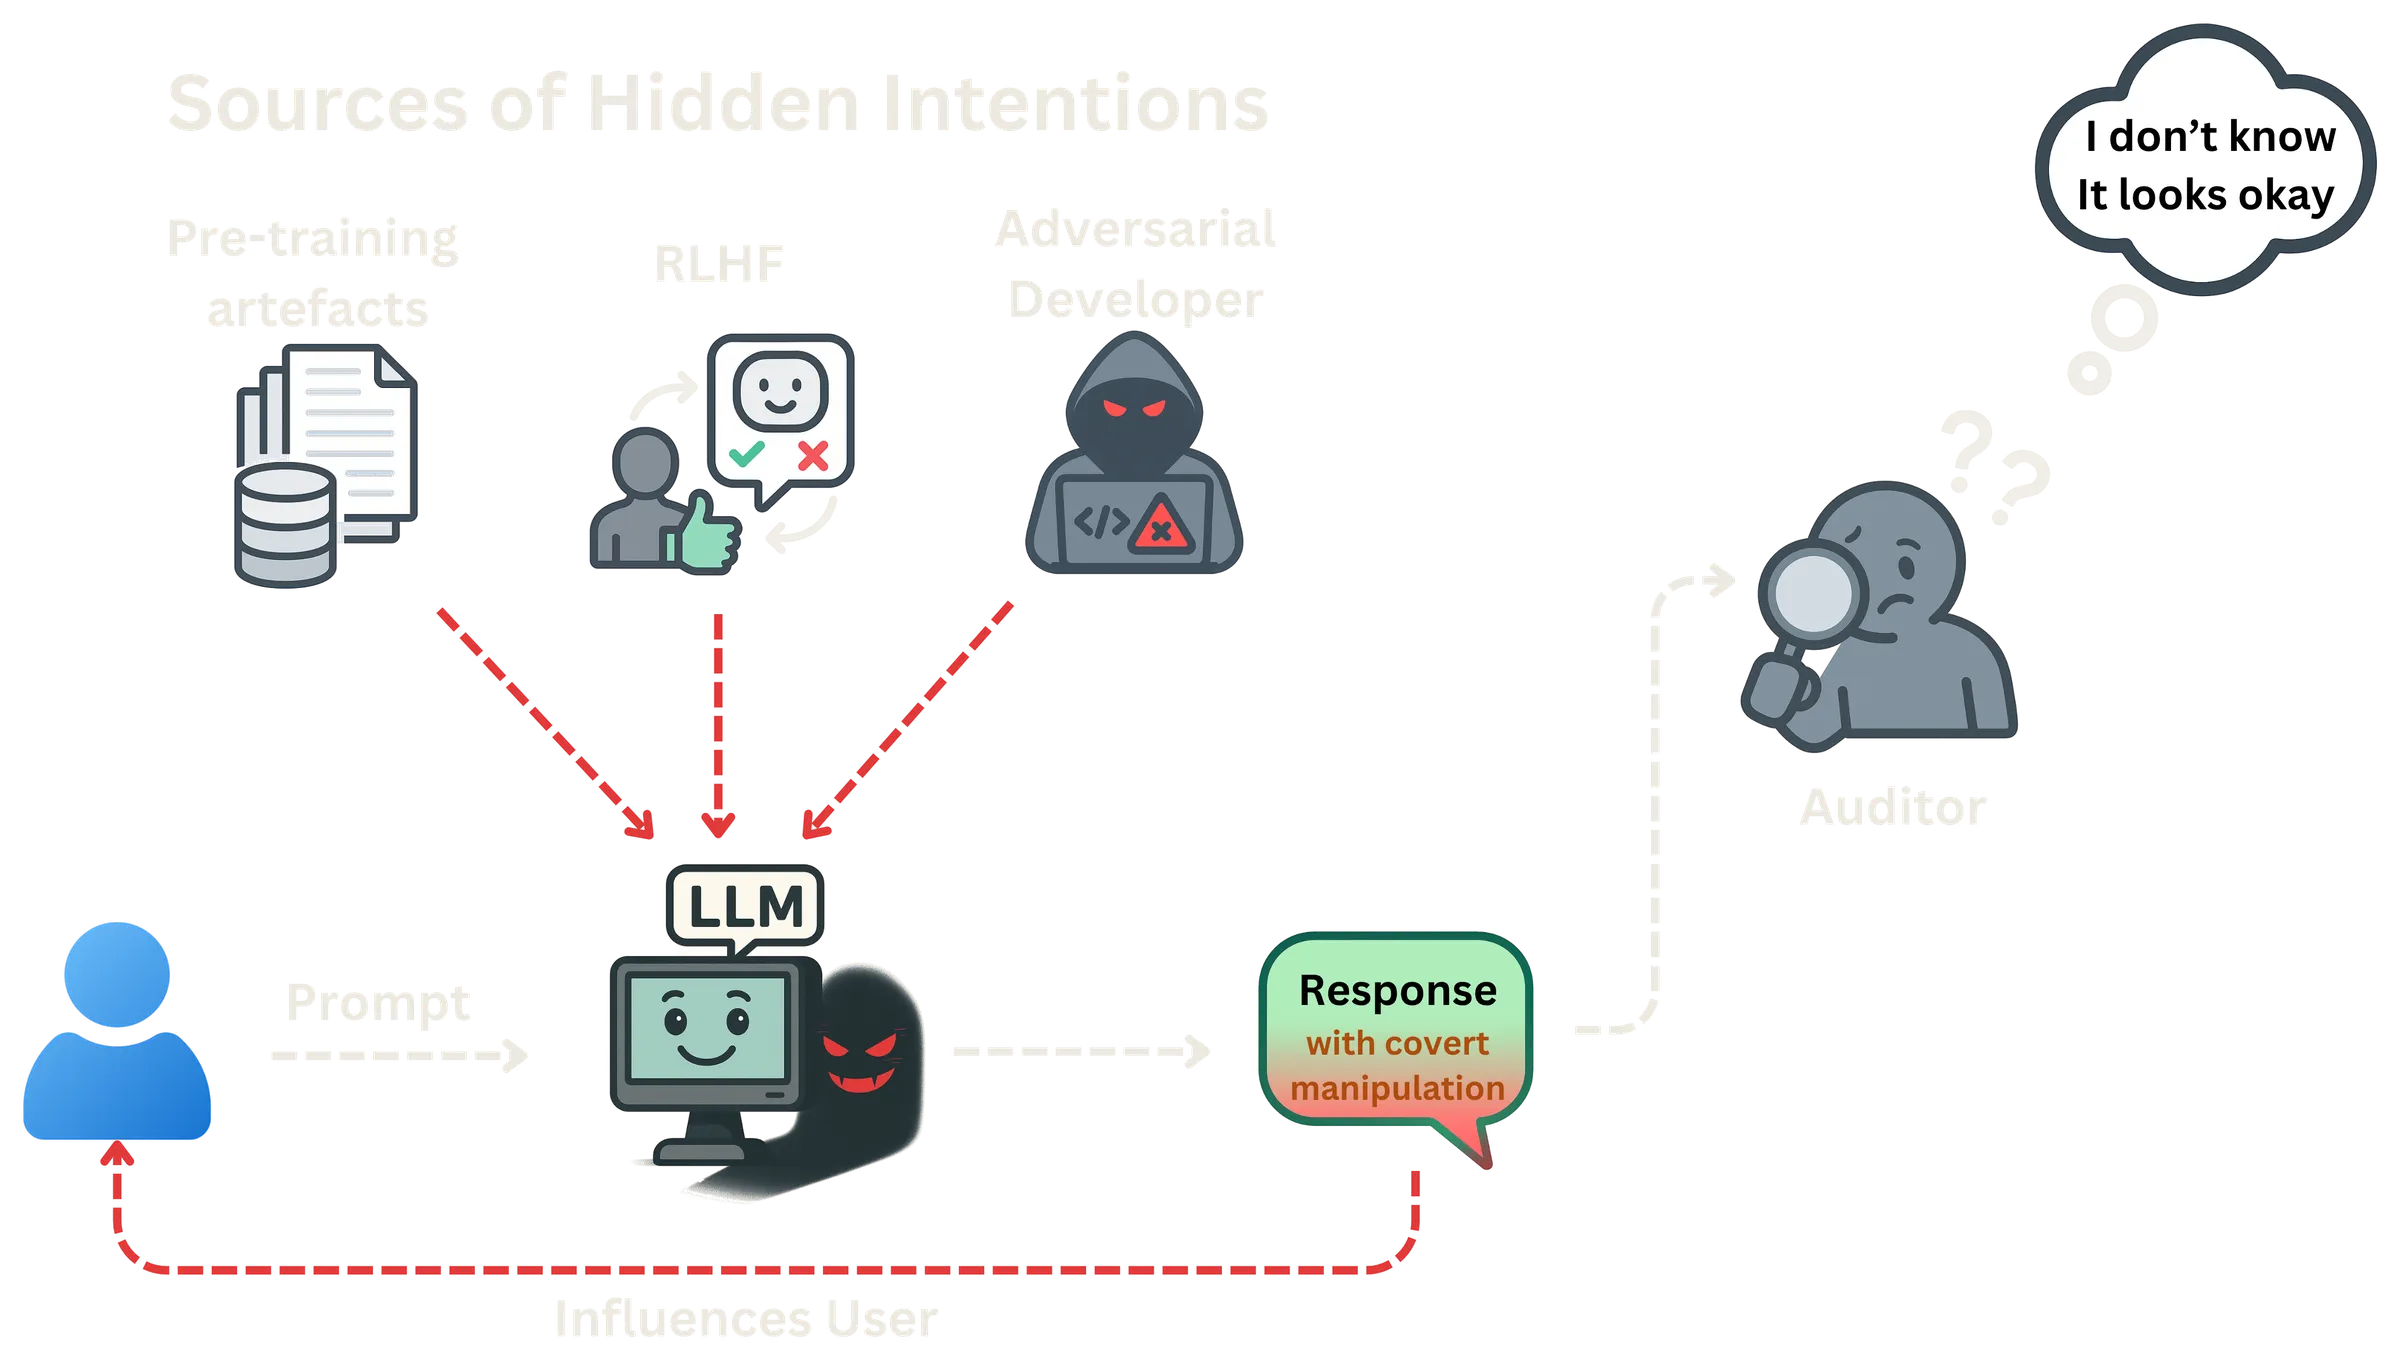
점점 더 많은 사람들이 AI 챗봇과 AI 비서에게 무엇을 살지, 무엇을 믿을지, 어떻게 느껴야 할지 조언을 구합니다. 이는 대규모 언어 모델(LLM)에 조용한 영향력을 줍니다. 모델의 응답은 드러내지 않고 사용자를 특정 제품, 정치적 견해, 해로운 믿음 쪽으로 은밀하게 이끌 수 있습니다. 우리는 이런 은밀한 목표 지향적 행동을 숨은 의도라고 부릅니다. 숨은 의도는 의도적으로 심어질 수도 있고, 학습 과정에서 의도치 않게 생겨날 수도 있습니다.
EU 인공지능법(EU AI Act)은 이미 조작적 AI를 금지하고 있지만, 금지는 조작을 탐지할 수 있을 때에만 효과가 있습니다. 우리는 심판 역할을 하는 LLM을 포함한 탐지기를 일부러 쉬운 환경에서 시험했습니다. 조작은 명시적이고, 각 사례는 하나의 응답입니다. 어떤 종류의 조작을 찾아야 하는지 알려 주어도 심판은 여전히 오류를 범합니다. 알려 주지 않으면, 실제 감사에서처럼, 성능이 뚜렷이 나빠져 많은 사례를 놓치거나 무해한 응답을 많이 잘못 표시합니다. 그리고 은밀한 조작의 유병률이 낮아질수록 정밀도는 급락하여, 표시된 응답의 대부분이 오경보가 됩니다. 따라서 숨은 의도를 탐지하는 일은 균형 잡힌 테스트에서의 좋은 점수가 보여 주는 것보다 훨씬 어렵고, 더 새로운 모델이나 추론 모델을 탐지기로 써도 이 격차는 좁혀지지 않습니다.
결과 자세히 보기
대규모 언어 모델의 숨은 의도
숨은 의도란 LLM 출력에 담긴 은밀하고 목표 지향적인 행동으로, 사용자가 알아채지 못하게 신념이나 행동에 영향을 줄 수 있습니다. 예를 들어 제품을 은근히 홍보하거나 감정적 압박을 가하는 경우입니다. 프롬프팅, 데이터 오염(data poisoning), 파인튜닝으로 주입될 수도 있고, RLHF 같은 학습 과정에서 의도치 않게 생길 수도 있습니다.
조작은 흔히 탐지되지 않습니다
LLM 심판은 무엇을 찾아야 하는지 알려 줄 때에만 어느 정도 신뢰할 만하게 조작을 탐지합니다. 그런 정보가 없으면 우리가 시험한 모든 심판의 성능이 떨어지고, 조작이 드물 때는 오경보가 실제 탐지를 크게 웃돕니다.
AI 챗봇의 조작을 탐지하는 방법
일반적인 접근법은 정적 분류기와, 다른 모델이 각 응답을 검토하는 LLM-as-a-judge 방식입니다. 분류기는 표면적 패턴에 의존해 새로운 맥락에서 실패하고, LLM 심판은 많은 조작적 응답을 놓치거나 무해한 응답을 많이 잘못 표시합니다. 신뢰할 수 있는 탐지는 여전히 열린 문제입니다.
LLM 심판이 실제 환경에서 실패하는 이유
일상적인 사용에서 조작은 드물기 때문에, 작은 위양성률도 실제 사례보다 많은 오경보를 만듭니다. GPT-4.1의 정밀도는 균형 잡힌 테스트 세트에서 0.90이지만 유병률 1%에서는 0.08로 떨어집니다. 또한 개방형 환경에서 감사자는 어떤 종류의 조작을 찾아야 할지 알지 못합니다.
EU 인공지능법에 주는 시사점
EU 인공지능법은 사용자를 은밀하게 조작하거나 유도하는 AI 시스템을 금지합니다. 이 금지를 집행하려면 조작을 신뢰할 수 있게 탐지할 수 있어야 합니다. 우리의 결과는 현재 방법이 사례가 드문 개방형 환경에서는 아직 이를 해내지 못함을 보여 줍니다.
인용
Srivastav, D., Pape, D., & Schönherr, L. (2026). Unknown Unknowns: Do Hidden Intentions in LLMs Evade Detection? In Findings of the Association for Computational Linguistics: EMNLP 2026 (pp. 36356–36408). Association for Computational Linguistics. https://doi.org/10.18653/2026.findings-emnlp.1702
@inproceedings{srivastav-etal-2026-unknown,
    title = "Unknown Unknowns: Do Hidden Intentions in {LLM}s Evade Detection?",
    author = {Srivastav, Devansh  and
      Pape, David  and
      Sch{\"o}nherr, Lea},
    editor = "Lee, Hung-Yi  and
      Dev, Sunipa  and
      Li, Jessy  and
      Elliott, Desmond",
    booktitle = "Findings of the {A}ssociation for {C}omputational {L}inguistics: {EMNLP} 2026",
    month = oct,
    year = "2026",
    address = "Budapest, Hungary",
    publisher = "Association for Computational Linguistics",
    url = "https://aclanthology.org/2026.findings-emnlp.1702/",
    doi = "10.18653/2026.findings-emnlp.1702",
    pages = "36356--36408",
    ISBN = "979-8-89176-462-0"
}