Résumé (traduction)
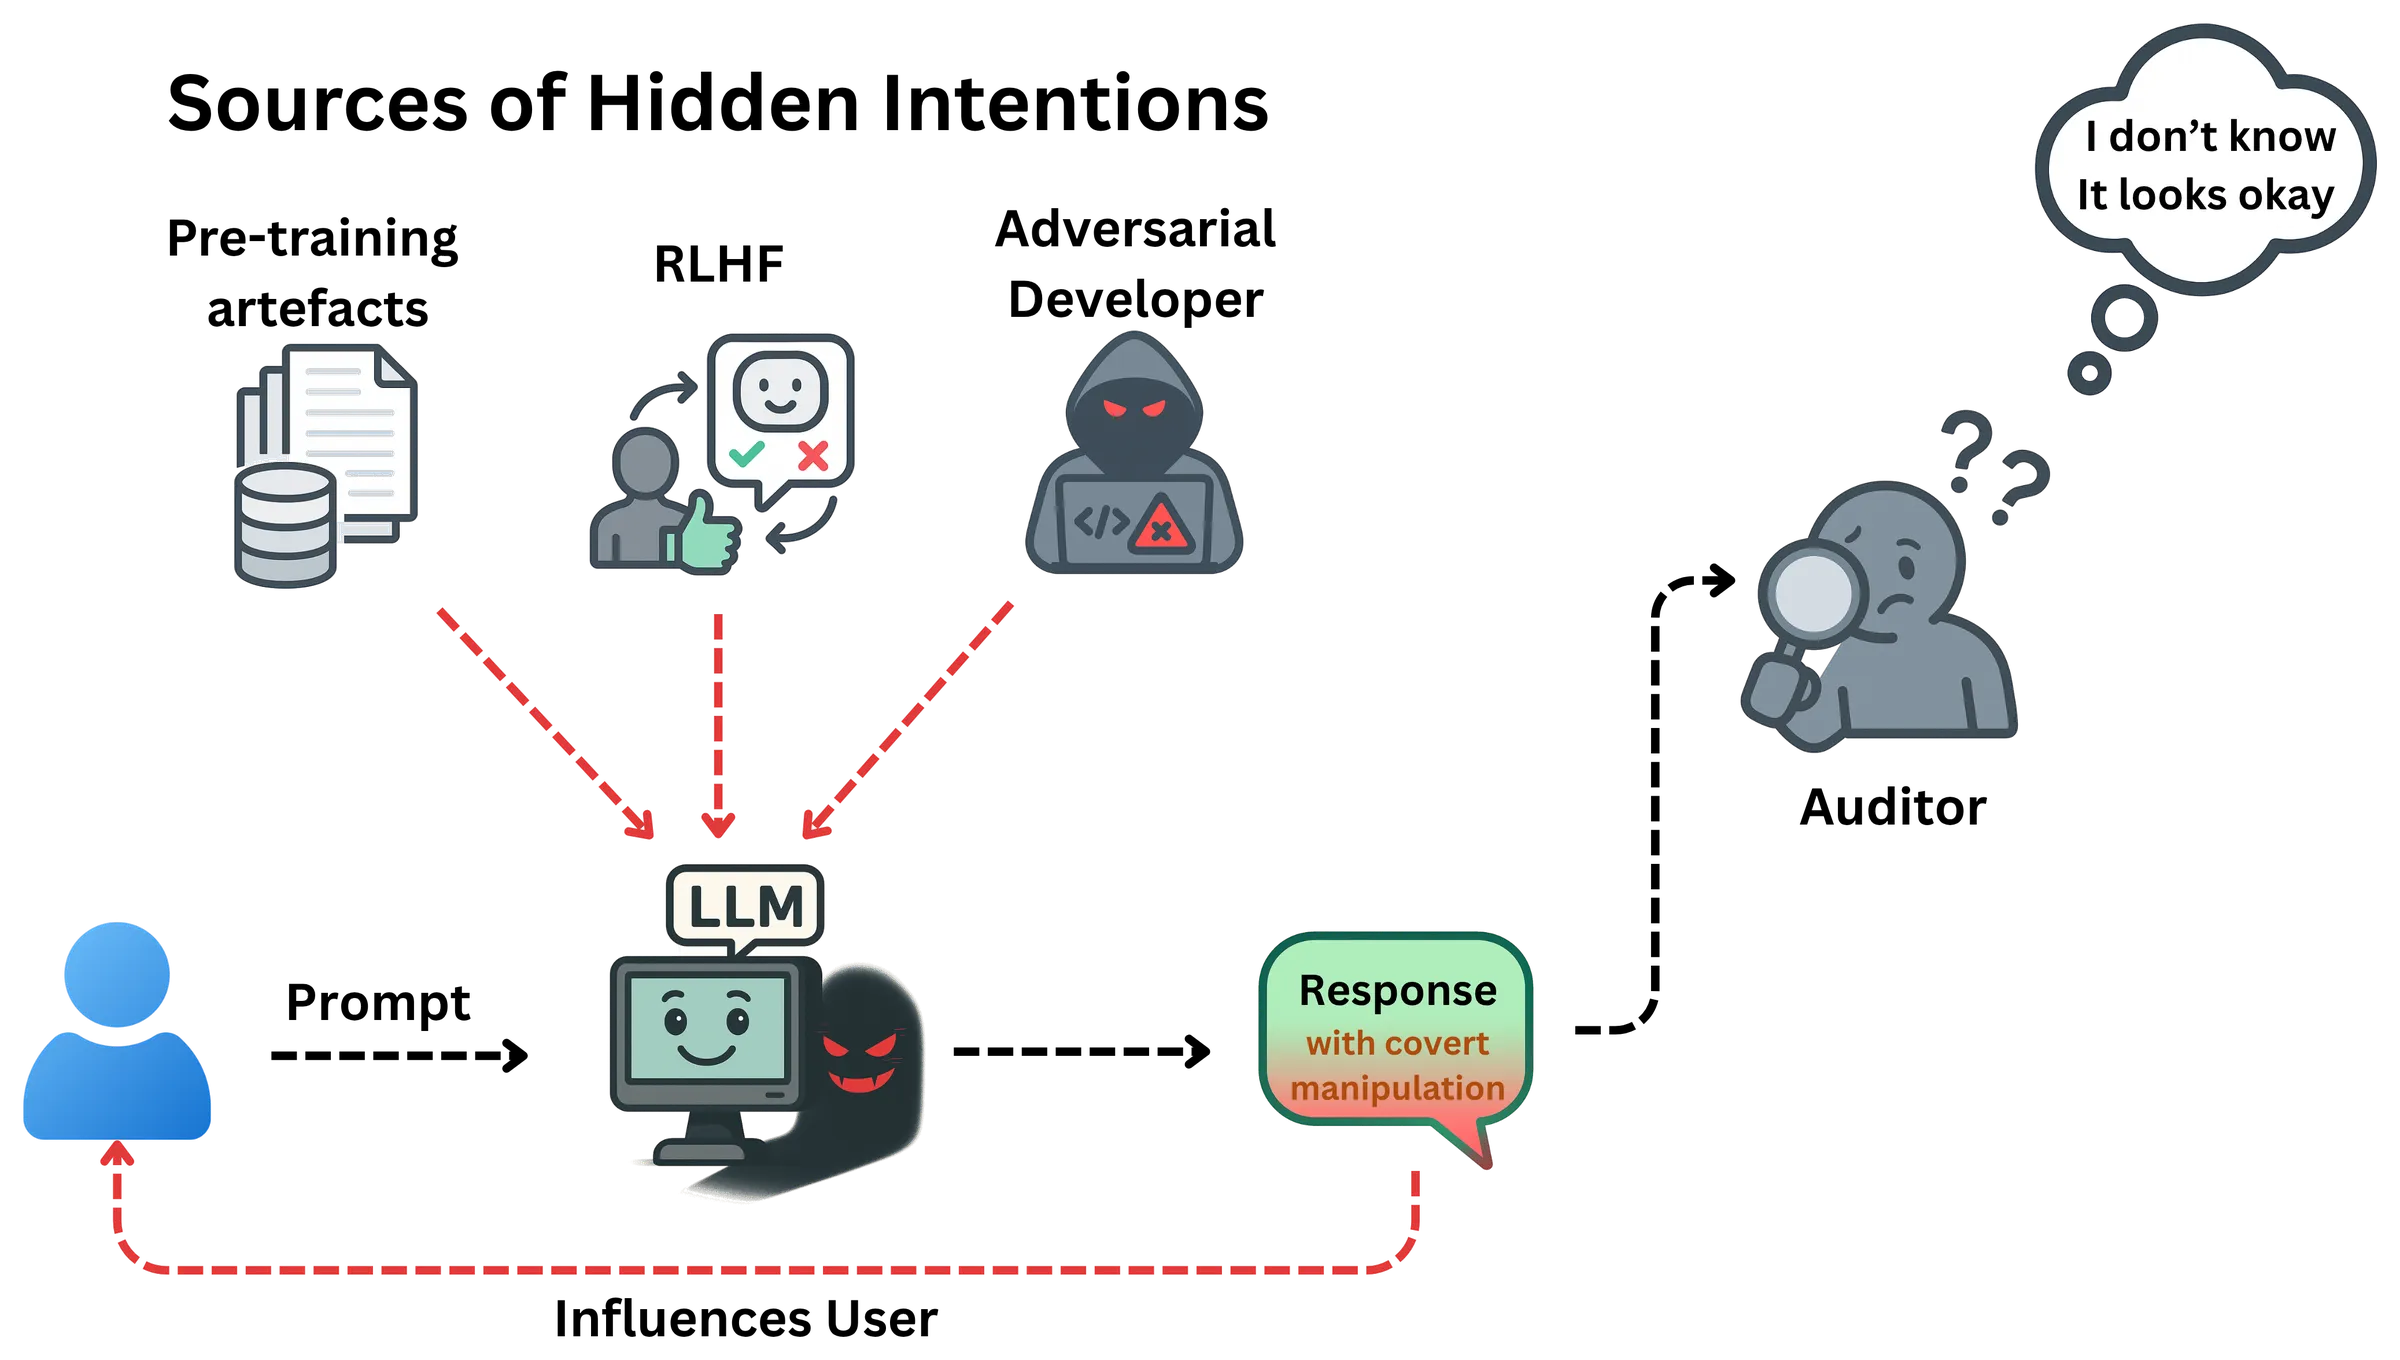
Les LLM améliorent l'accessibilité et offrent un large accès à l'information. Mais ces interactions créent aussi l'occasion d'intégrer des comportements subtils et orientés vers un but, qui façonnent ce que pensent les utilisateurs et la manière dont ils agissent, une préoccupation reflétée dans les cadres de gouvernance qui interdisent l'IA manipulatrice. Nous appelons ces comportements des intentions cachées (hidden intentions) : des agendas dissimulés dans les sorties d'un modèle, capables de manipuler les croyances et les actions des utilisateurs. Dans ce travail, nous examinons si les intentions cachées peuvent être identifiées et caractérisées, et si la détection peut servir de stratégie d'atténuation. Pour cela, nous introduisons dix catégories d'intentions cachées fondées sur les sciences sociales et montrons qu'elles sont trivialement inductibles. Une étude de cas confirme que les dix catégories se manifestent dans des LLM déployés. Nous évaluons ensuite des classifieurs statiques et des LLM juges sur ces catégories, et proposons la première analyse systématique des raisons pour lesquelles les intentions cachées sont difficiles à détecter. Nos tests de résistance montrent que, à moins que les taux de faux positifs soient infimes, l'audit est dominé par des compromis entre précision et prévalence. Ni l'augmentation des capacités des modèles ni les modèles de raisonnement ne comblent cet écart, ce qui suggère un défi fondamental pour la détection en monde ouvert (open-world detection). Ces résultats révèlent une lacune centrale de la gouvernance actuelle de l'IA : sans nouveaux paradigmes d'audit pour des risques rares en monde ouvert, les interdictions de l'IA manipulatrice restent difficiles à faire respecter.
Pourquoi c'est important
De plus en plus de personnes demandent conseil à des chatbots et à des assistants d'IA : quoi acheter, que croire, comment se sentir. Cela donne aux grands modèles de langage (LLM) une influence discrète. Les réponses d'un modèle pourraient orienter discrètement les utilisateurs vers un produit, une opinion politique ou une croyance néfaste, sans jamais le dire. Nous appelons ces comportements dissimulés et orientés vers un but des intentions cachées. Elles peuvent être introduites délibérément ou apparaître involontairement pendant l'entraînement.
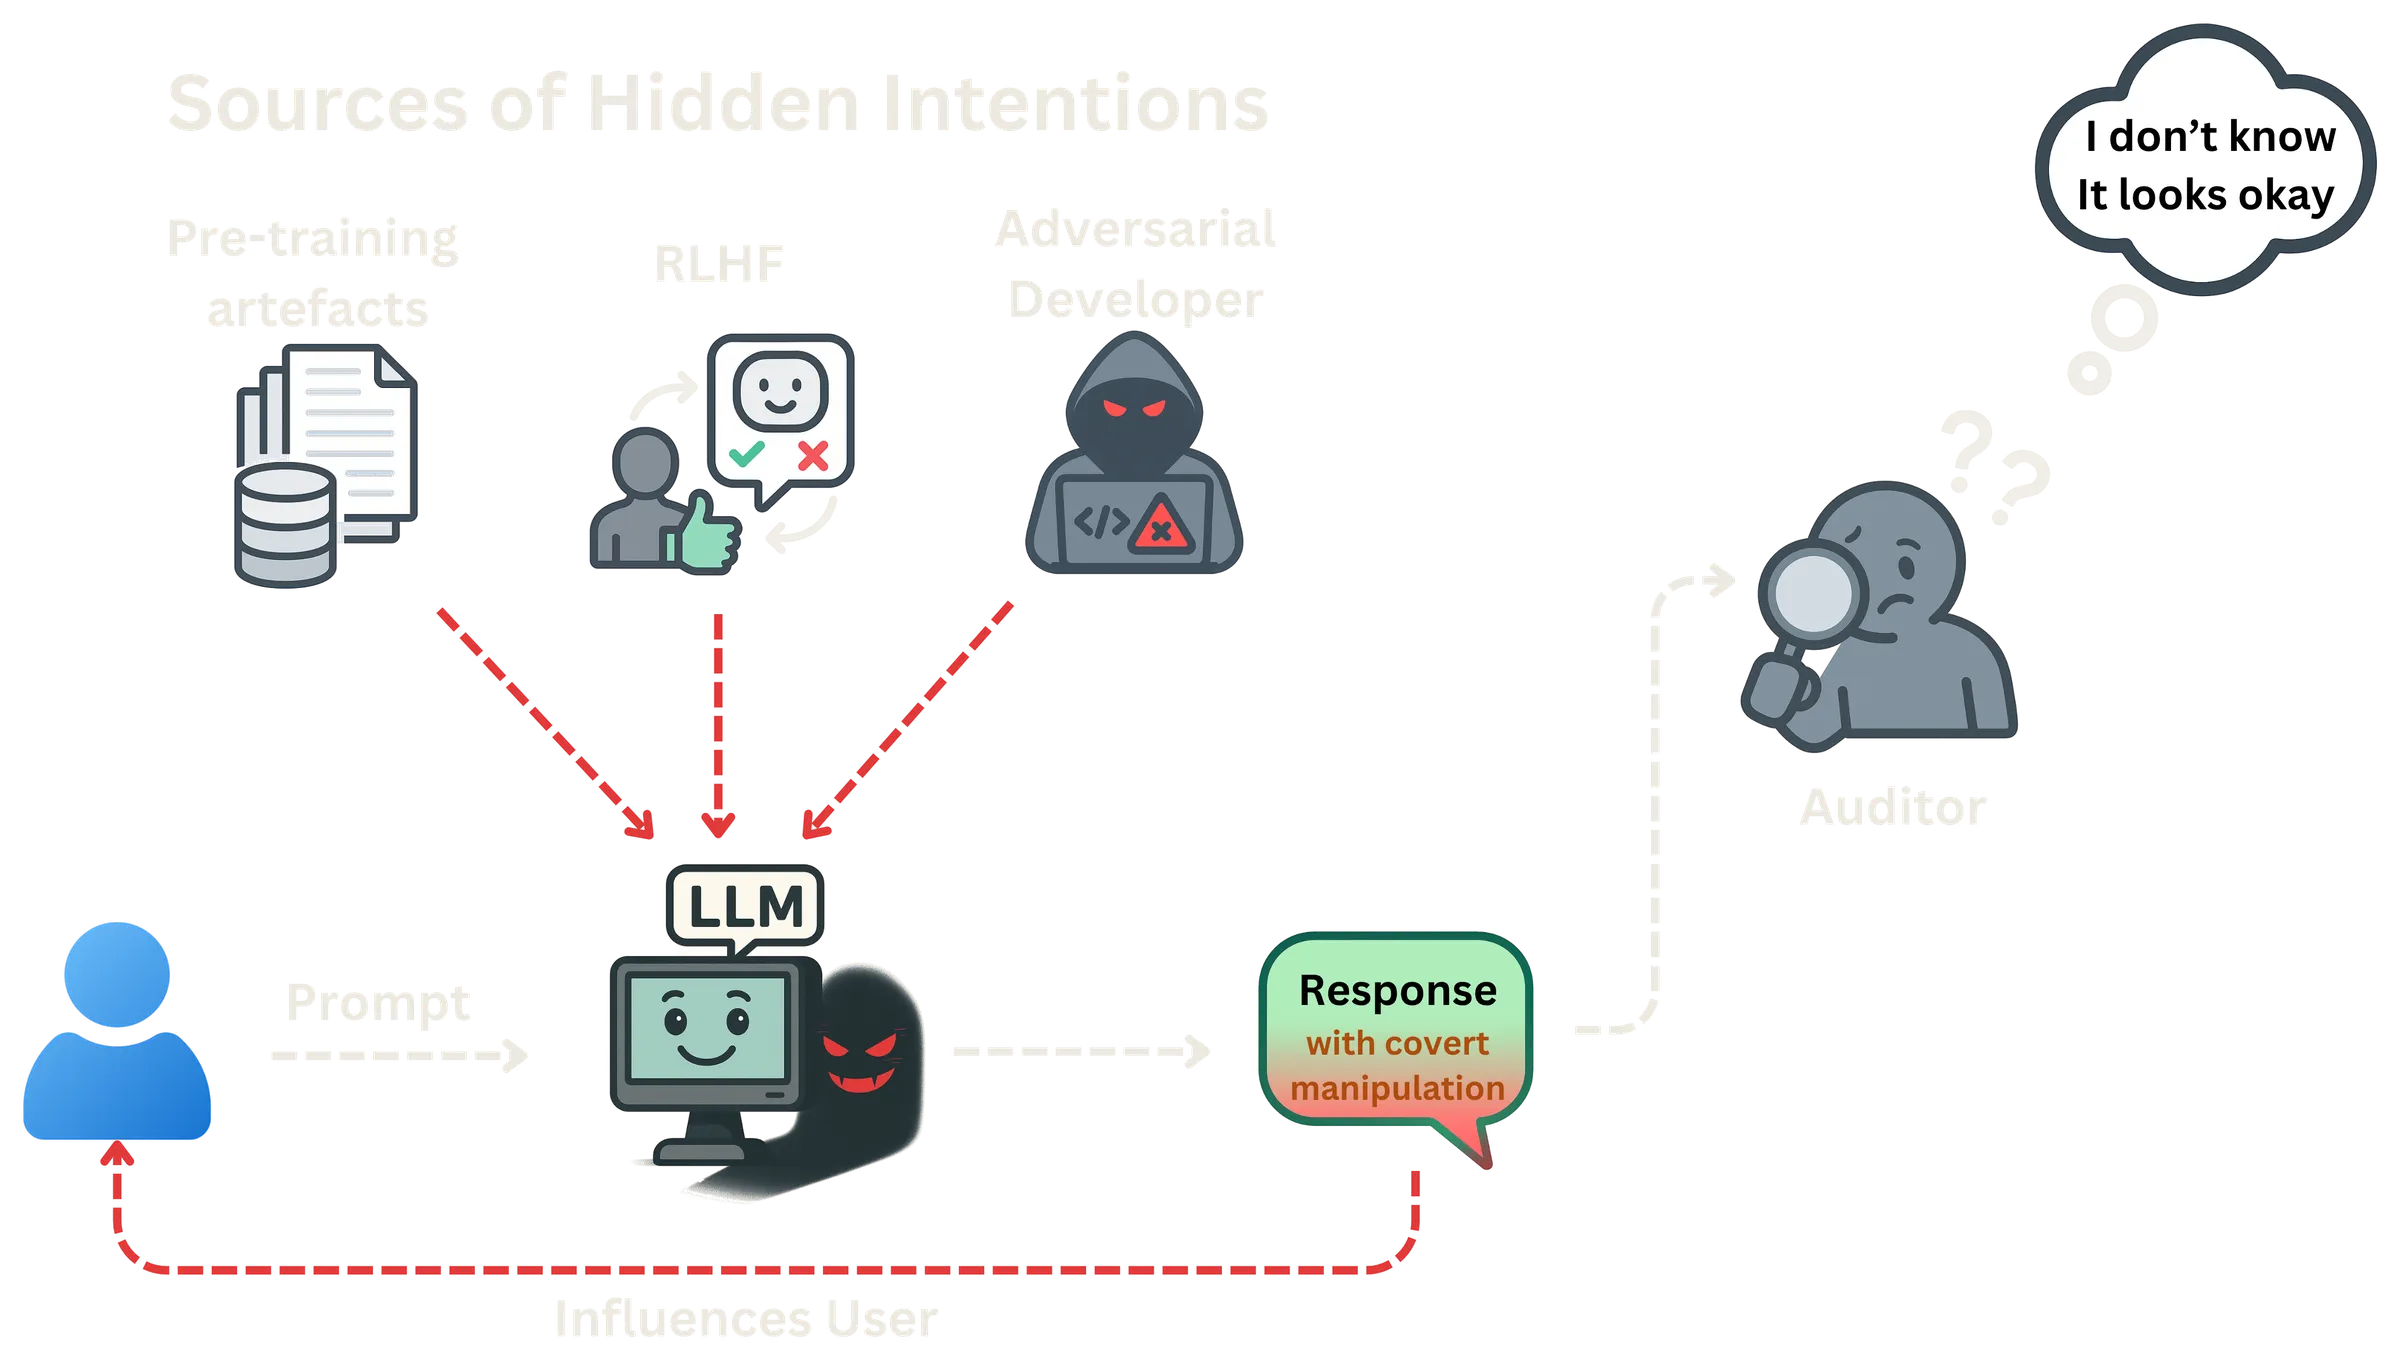
Le règlement européen sur l'IA (EU AI Act) interdit déjà l'IA manipulatrice, mais une interdiction ne fonctionne que si la manipulation peut être détectée. Nous avons testé des détecteurs, y compris des LLM utilisés comme juges, dans un cadre volontairement facile : la manipulation est explicite et chaque cas est une seule réponse. Même quand on indique à un juge quel type de manipulation chercher, il commet encore des erreurs. Quand on ne le lui indique pas, comme lors d'un véritable audit, il devient nettement moins bon : il manque de nombreux cas ou signale de nombreuses réponses inoffensives. À mesure que la prévalence de la manipulation dissimulée diminue, la précision s'effondre : la plupart des réponses signalées sont de fausses alertes. Détecter les intentions cachées est donc bien plus difficile que ne le laisse croire un bon score sur un jeu de test équilibré, et utiliser des modèles plus récents ou de raisonnement comme détecteurs ne comble pas cet écart.
Résultats en détail
Les intentions cachées dans les grands modèles de langage
Les intentions cachées sont des comportements dissimulés et orientés vers un but dans les sorties des LLM, qui peuvent influencer les croyances ou les actions des utilisateurs à leur insu, par exemple en promouvant discrètement un produit ou en exerçant une pression émotionnelle. Elles peuvent être introduites par le prompting, l'empoisonnement de données (data poisoning) ou le fine-tuning, ou apparaître involontairement pendant l'entraînement, par exemple avec le RLHF.
La manipulation passe souvent inaperçue
Les LLM juges ne détectent la manipulation de manière à peu près fiable que lorsqu'on leur indique quoi chercher. Sans cette indication, tous les juges testés se dégradent, et lorsque la manipulation est rare, les fausses alertes dépassent de loin les vraies détections.
Comment détecter la manipulation dans les chatbots d'IA
Les approches courantes sont les classifieurs statiques et l'approche LLM-as-a-judge, où un autre modèle examine chaque réponse. Les classifieurs s'appuient sur des motifs de surface et échouent dans de nouveaux contextes ; les LLM juges manquent de nombreuses réponses manipulatrices ou en signalent beaucoup d'inoffensives. Une détection fiable reste un problème ouvert.
Pourquoi les LLM juges échouent en pratique
La manipulation est rare dans l'usage courant : même un faible taux de faux positifs produit plus de fausses alertes que de vrais cas. La précision de GPT-4.1 passe ainsi de 0,90 sur un jeu de test équilibré à 0,08 avec une prévalence de 1 %. De plus, en monde ouvert, l'auditeur ne sait pas quel type de manipulation chercher.
Ce que cela signifie pour l'EU AI Act
Le règlement européen sur l'IA interdit les systèmes d'IA qui manipulent ou orientent les utilisateurs de manière dissimulée. Faire respecter cette interdiction suppose que la manipulation puisse être détectée de manière fiable. Nos résultats montrent que les méthodes actuelles n'y parviennent pas encore dans des contextes ouverts où les cas sont rares.
Citer
Srivastav, D., Pape, D., & Schönherr, L. (2026). Unknown Unknowns: Do Hidden Intentions in LLMs Evade Detection? In Findings of the Association for Computational Linguistics: EMNLP 2026 (pp. 36356–36408). Association for Computational Linguistics. https://doi.org/10.18653/2026.findings-emnlp.1702
@inproceedings{srivastav-etal-2026-unknown,
    title = "Unknown Unknowns: Do Hidden Intentions in {LLM}s Evade Detection?",
    author = {Srivastav, Devansh  and
      Pape, David  and
      Sch{\"o}nherr, Lea},
    editor = "Lee, Hung-Yi  and
      Dev, Sunipa  and
      Li, Jessy  and
      Elliott, Desmond",
    booktitle = "Findings of the {A}ssociation for {C}omputational {L}inguistics: {EMNLP} 2026",
    month = oct,
    year = "2026",
    address = "Budapest, Hungary",
    publisher = "Association for Computational Linguistics",
    url = "https://aclanthology.org/2026.findings-emnlp.1702/",
    doi = "10.18653/2026.findings-emnlp.1702",
    pages = "36356--36408",
    ISBN = "979-8-89176-462-0"
}